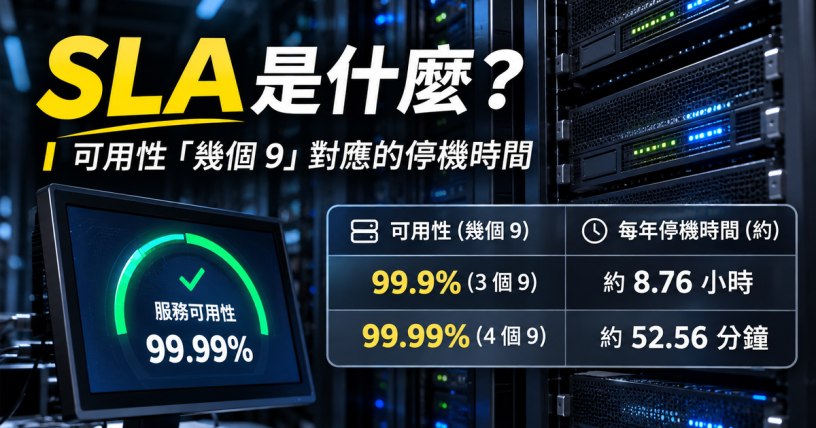
SLA 是什麼?SLA 是 Service Level Agreement 的縮寫,Microsoft 的繁體中文文件譯作「服務等級協定」,也常見「服務等級協議」的寫法。它是服務提供者和客戶之間的合約,寫明服務要達到什麼水準,以及沒達到時提供者要負什麼責任。合約裡最常出現的數字是可用性(Availability),例如 99.9% 或 99.99%,口語上用「幾個 9」來稱呼。
可用性是高可用性(HA)架構要達成的目標。這篇只講這個數字怎麼算、對應多少停機時間;叢集與故障切換的做法請看 HA 那篇。
可用性怎麼算
AWS Well-Architected 可靠性支柱對可用性的定義,是工作負載可供使用的時間百分比:
可用性 = 可供使用的時間 ÷ 總時間「可供使用」指的是服務在需要時能成功執行約定好的功能。計算期間通常取一個月或一年。
服務不容易用時間切分時,也可以改用請求數來算:成功回應的數量除以有效請求的數量。AWS 文件提到,常見做法是以一分鐘或五分鐘為一個區間計算,再把各區間平均成每月的可用性;某個區間完全沒有請求時,該區間視為 100% 可用。
幾個 9 對應的停機時間對照表
「幾個 9」是數可用性百分比裡有幾個 9:99% 是兩個 9,99.9% 是三個 9,99.999% 是五個 9。Google 的 SRE 書把 99.95% 稱為「三個半 9」。
下表是各個可用性允許的最長停機時間。計算基準為一年 365 天、一個月取一年的十二分之一(730 小時)、一天 24 小時。
| 可用性 | 每年可停機 | 每月可停機 | 每日可停機 |
|---|---|---|---|
| 99%(兩個 9) | 3 天 15 小時 36 分 | 7 小時 18 分 | 14 分 24 秒 |
| 99.9%(三個 9) | 8 小時 45 分 36 秒 | 43 分 48 秒 | 1 分 26.4 秒 |
| 99.95%(三個半 9) | 4 小時 22 分 48 秒 | 21 分 54 秒 | 43.2 秒 |
| 99.99%(四個 9) | 52 分 33.6 秒 | 4 分 22.8 秒 | 8.64 秒 |
| 99.999%(五個 9) | 5 分 15.4 秒 | 26.3 秒 | 0.86 秒 |
每多一個 9,可停機時間就剩十分之一。有些對照表的每月欄位用 30 天計算,數字會略小(例如五個 9 是 25.9 秒),比較不同表格時要先確認基準。
AWS 文件列了各級距常見的應用類型:99% 是批次處理與資料擷取、轉換、載入工作;99.9% 是知識管理、專案追蹤這類內部工具;99.95% 是線上商務與銷售點系統;99.99% 是影片傳遞與廣播;99.999% 是 ATM 交易與電信。同一份文件也提醒,可用性目標越高,測試、自動化復原與維運的成本都跟著提高,動手設計前要先確認真正需要的等級。
SLA、SLO、SLI 的差別
這三個名詞常被混用。依 Google SRE 書的定義:
- SLI(Service Level Indicator,服務等級指標):服務水準某個面向的量化測量值,例如可用性、延遲、錯誤率。
- SLO(Service Level Objective,服務等級目標):替 SLI 訂的目標值或範圍,例如「每月可用性 99.9% 以上」。
- SLA(Service Level Agreement):和使用者之間的契約,包含達成或沒達成 SLO 時的後果。
要分辨一個數字是 SLO 還是 SLA,Google 的判斷方式是問「沒達標會怎樣」:沒有明訂後果的,幾乎都是 SLO。Microsoft 的 Azure Well-Architected 文件也是同樣的區分:SLA 是組織和客戶之間的正式合約,違反時有直接的財務與法律影響;SLO 是組織內部用來判斷停機是否還在可容忍範圍的目標。
以 Amazon EC2 的 SLA 為例(條款頁標示最後更新於 2022 年 5 月 25 日):區域層級的每月正常運作時間百分比承諾至少 99.99%,低於 99.99% 但不低於 99.0% 時退還 10% 的服務抵用金,低於 99.0% 但不低於 95.0% 退還 30%,低於 95.0% 退還 100%。
讀 SLA 時,百分比之外還要看兩件事:
- 「無法使用」怎麼定義:EC2 區域層級的定義,是同一個區域內兩個以上可用區域裡所有執行中的執行個體同時失去對外連線。單一執行個體另有執行個體層級的承諾,數字是至少 99.5%,兩者不能混為一談。
- 排除條款:EC2 的 SLA 不涵蓋不可抗力、客戶自己的操作或設備造成的中斷。
Microsoft 文件也提醒,雲端平台的 SLA 只保證條款寫到的範圍,沒有明列的功能應視為盡力而為,不能直接把平台的 SLA 當成自己系統的 SLO。
計畫性維護算不算停機
要看合約或目標怎麼定義,沒有統一答案。
AWS 文件的說法是:採最嚴格的解釋,只要應用程式沒有正常運作,可用性就下降,計畫內和計畫外的中斷都算。有些團隊會把計畫性維護的時間從算式的「總時間」裡扣掉,AWS 不建議這麼做,因為使用者在維護時段很可能也想使用服務。
Microsoft 文件裡的範例團隊也做了同樣的選擇:他們的 API 每天有一段時間幾乎沒人使用,可以把維護排在那裡,但決定不把維護時段排除在 SLO 之外。
所以拿到一個可用性數字時,要先確認計算期間(每月還是每年),以及維護時段有沒有被排除,兩個 99.9% 才能比較。
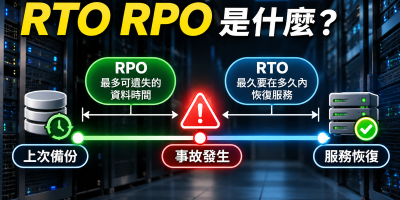
可用性衡量的是一段期間內的平均表現。AWS 文件把天災、大規模故障這類一次性事故另外用災難復原目標來規範,也就是 RTO 與 RPO。
硬相依會把可用性往下拉
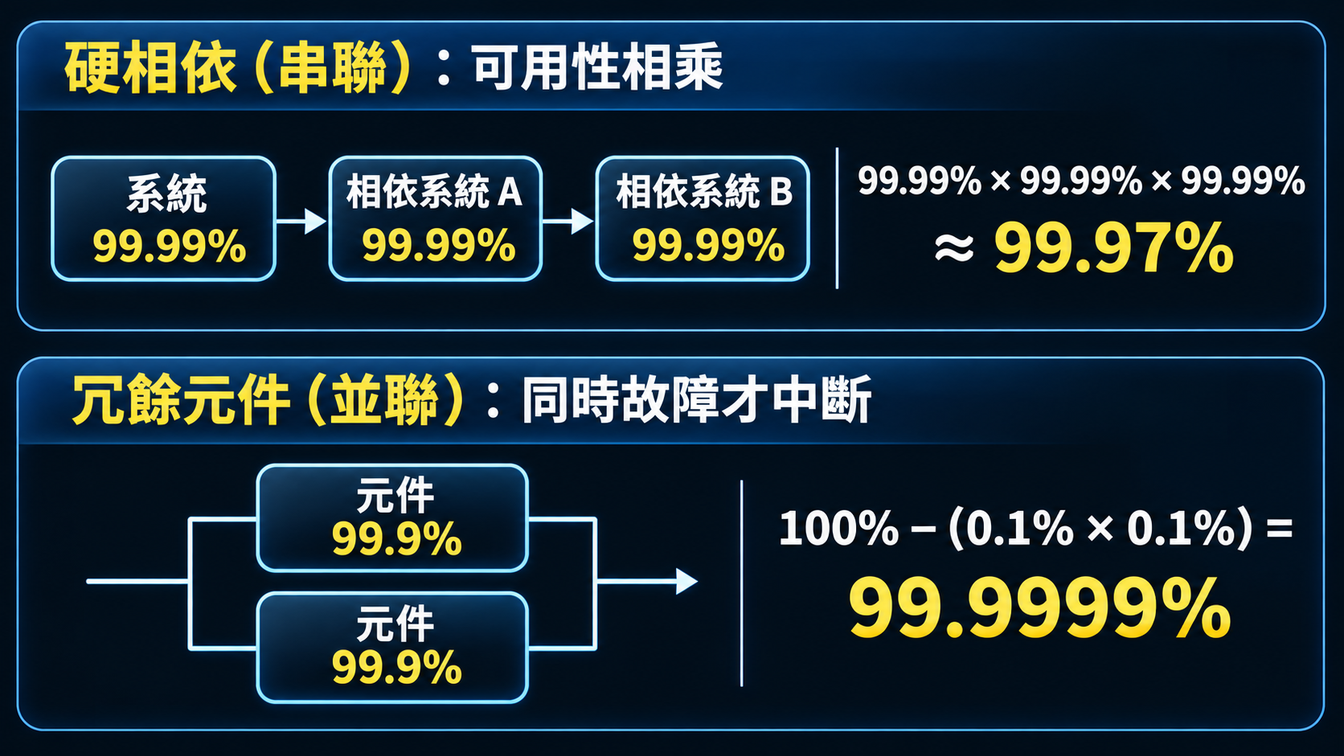
硬相依(hard dependency)是指被依賴的系統一中斷,呼叫它的系統也跟著中斷。這種情況下,整體可用性是各個系統可用性的乘積。
AWS 文件的例子:一個設計為 99.99% 的系統,硬相依於另外兩個各自 99.99% 的獨立系統,理論上整體只能達到 99.97%。
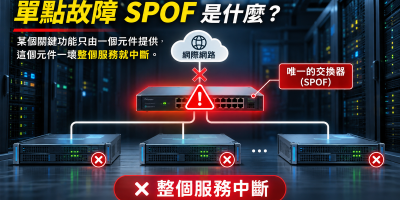
99.99% × 99.99% × 99.99% ≈ 99.97%換算成每年停機時間,99.99% 是約 52.6 分鐘,99.97% 是約 2 小時 38 分鐘。串接的硬相依越多,整體可用性越低,所以訂自己的目標前要先盤點相依的服務和它們各自的可用性。相依性怎麼盤點、哪些會成為單點故障(SPOF),另有一篇說明。
相對的概念是軟相依(soft dependency):被依賴的系統故障時,應用程式自己有辦法補償,不會直接跟著中斷。
冗餘元件會把可用性往上拉
同一個功能由多個彼此獨立的冗餘元件提供時,只有全部同時故障才算中斷。理論可用性是 100% 減去各元件故障率的乘積。
AWS 文件的例子:兩個獨立元件各自 99.9%,組合後的有效可用性是 99.9999%。
100% −(0.1% × 0.1%)= 99.9999%AWS 提供一個速算法:參與計算的可用性數字如果全由 9 組成,把 9 的個數加起來就是答案,兩個三個 9 的獨立冗餘元件得到六個 9。
這個算式的前提是元件彼此獨立。AWS 舉的例子是放在不同可用區域的備援資源;元件之間會一起故障的話,就不能這樣算。
參考資料與延伸閱讀
- AWS Well-Architected Framework 可靠性支柱:可用性
- Google SRE Book:Service Level Objectives
- Microsoft Azure Well-Architected Framework:定義可靠性目標的架構策略
- Amazon Compute Service Level Agreement
- 延伸閱讀:HA 是什麼?高可用性系統架構與故障切換設計實務
- 延伸閱讀:單點故障(SPOF)是什麼:Single Point of Failure 的意思、常見位置與消除方法
- 延伸閱讀:RTO RPO 是什麼:復原時間目標與復原點目標的定義、差異與備份頻率關係

發佈留言