把同一份資料放在多台伺服器上,是為了有機器故障時服務不中斷。問題在於:每台機器收到寫入的時間不同,有的會當機、有的會斷線,要怎麼確定大家手上的資料是同一份、順序也相同?Raft 共識演算法就是用來回答這個問題的,etcd 與 Consul 的官方文件都寫明自己採用它。
本文依 Raft 原始論文與官方文件,說明 Raft 是什麼、leader 怎麼選出來、寫入怎麼複製到其他機器、為什麼換了 leader 資料也不會遺失、叢集該放幾台,以及單一 leader 設計的已知限制。
想先了解高可用性架構、故障切換與雙節點腦裂(Split-Brain)的基礎,可前往 HA 是什麼?高可用性系統架構與故障切換設計實務 觀看。
什麼是 Raft
Raft 是一種共識演算法(consensus algorithm)。共識指的是多台伺服器對某個值達成一致,而且一旦決定就不再更改。Raft 讓一組伺服器對「同一份 log 的內容與順序」達成一致,即使其中少數幾台故障,整個叢集仍能繼續提供服務,而且不會回傳錯誤結果。
它由 Diego Ongaro 與 John Ousterhout 提出,論文標題是〈In Search of an Understandable Consensus Algorithm〉,這篇論文的精簡版在 2014 年 USENIX Annual Technical Conference 獲得最佳論文獎。
在 Raft 之前,共識演算法的代表是 Paxos;論文指出 Paxos 難以理解,也難以直接做成實際系統,所以 Raft 把「容易理解」當成設計目標。
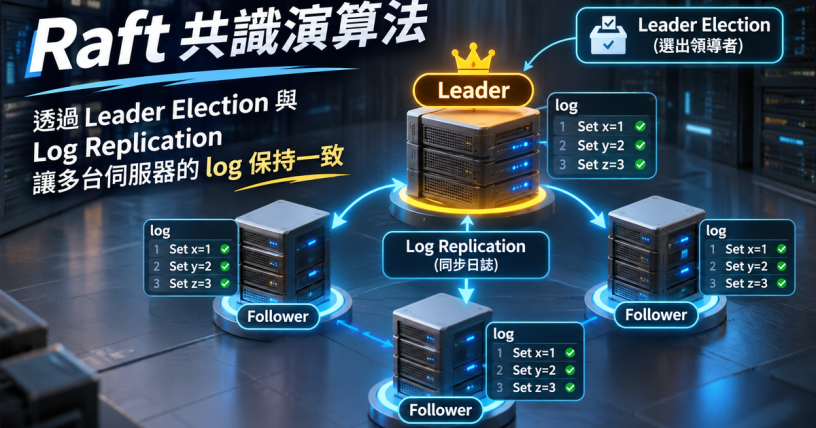
用一句話描述 Raft 的運作方式:先選出一台 leader,所有寫入都交給 leader,由它把寫入依序記進 log 並複製給其他伺服器;過半數伺服器存下之後,這筆寫入才算數。leader 故障時,剩下的伺服器再選一台新的。後面各節依序說明這幾件事:
- Leader Election:leader 怎麼選、故障後怎麼換人。
- Log Replication:寫入怎麼複製、何時算 committed。
- Safety:為什麼換了 leader,已 committed 的資料也不會遺失。
Raft 要解決的問題:複製狀態機
Raft 處理的情境叫做複製狀態機(replicated state machine)。每台伺服器各有一份 log 和一個狀態機,log 裡依序存放指令(例如「把 x 設為 3」)。只要每台伺服器的 log 內容與順序完全相同,各自的狀態機照順序執行後就會得到相同的狀態。共識演算法的工作,就是保證這份 log 在各台伺服器上一致。
論文列出實務上的共識演算法通常具備的性質,其中兩點最常被問到:
- 安全性不靠時間假設:在所有非拜占庭(non-Byzantine)條件下都不會回傳錯誤結果,包含網路延遲、網路分割、封包遺失、重複與亂序。
- 過半數可用就能運作:只要過半數伺服器正常、彼此與用戶端能通訊,叢集就可用。論文舉的例子是 5 台伺服器可以容忍任意 2 台故障。
「非拜占庭」的意思是 Raft 假設伺服器故障時是停止運作,而不是送出錯誤或惡意的訊息。節點會說謊的情境不在 Raft 的處理範圍內。
三種狀態與 term
任何時間點,每台伺服器只會處於三種狀態之一:
| 狀態 | 行為 |
|---|---|
| leader | 處理所有用戶端請求,把 log 複製給其他伺服器 |
| follower | 被動,只回應 leader 與 candidate 的請求;用戶端若連到 follower,會被轉給 leader |
| candidate | 選舉期間的過渡狀態,用來競選新的 leader |
正常運作時叢集只有一個 leader,其餘都是 follower。
Raft 把時間切成一段一段的 term,以連續整數編號。每個 term 從一次選舉開始:選出 leader,這個 leader 就負責到 term 結束;如果票數分散、沒有人過半,這個 term 就沒有 leader,接著開始下一個 term。Raft 保證一個 term 內最多只有一個 leader。
term 的作用相當於邏輯時鐘,用來辨識過期的資訊:
- 伺服器之間每次通訊都會交換目前的 term,看到比自己大的 term 就更新。
- candidate 或 leader 發現自己的 term 過期,立刻退回 follower。
- 收到帶有過期 term 的請求,直接拒絕。
基本的共識流程只需要兩種 RPC:RequestVote(candidate 在選舉時發出)與 AppendEntries(leader 用來複製 log,也兼作心跳)。傳送快照另外用第三種 InstallSnapshot。
Leader Election:心跳、election timeout 與投票規則
Raft 用心跳觸發選舉。leader 會定期對所有 follower 送出不帶 log 的 AppendEntries 當作心跳;follower 如果在一段稱為 election timeout 的時間內沒收到任何訊息,就認定目前沒有可用的 leader,開始選舉。
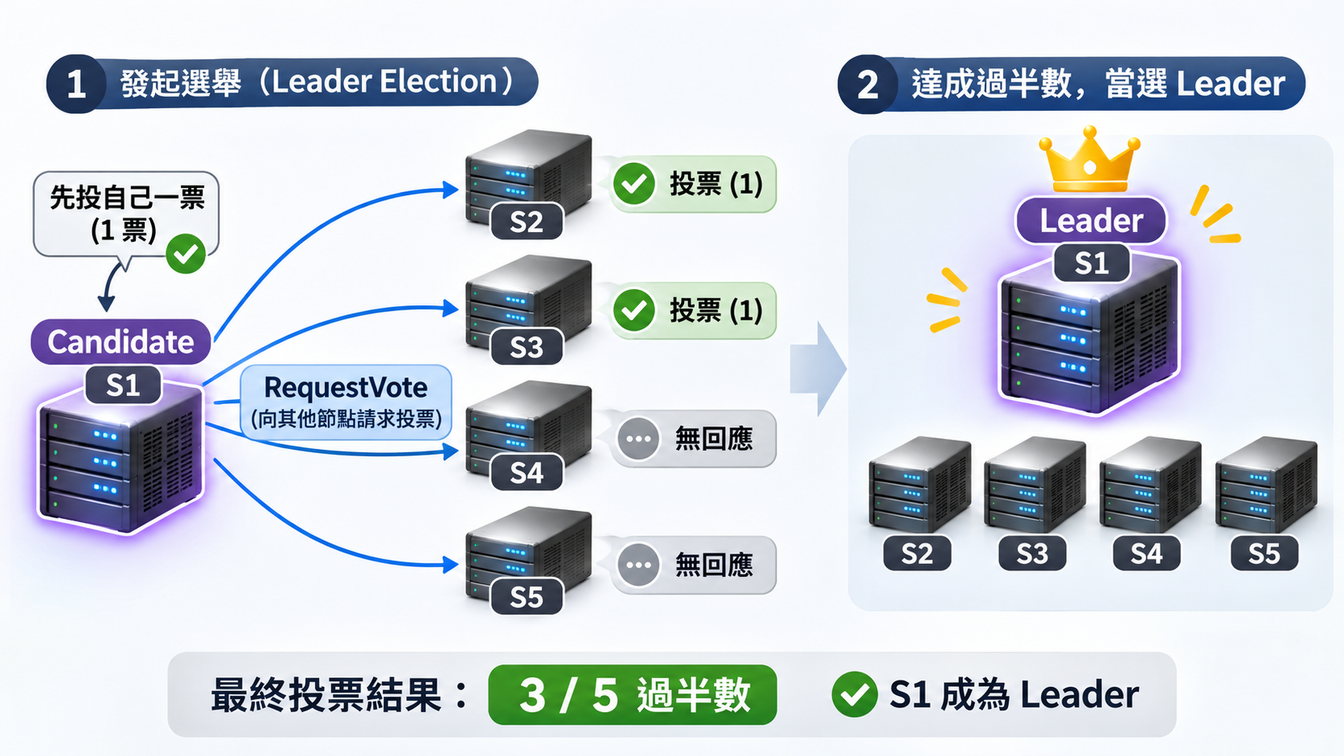
選舉流程如下:
- follower 把自己的 term 加 1,轉為 candidate。
- 先投自己一票,並同時對其他所有伺服器送出
RequestVote。 - 等待結果,結局有三種:
- 拿到整個叢集過半數的票,成為 leader,立刻送出心跳宣告身分。
- 收到別台伺服器的
AppendEntries,而且對方的 term 不小於自己,承認對方是 leader,退回 follower。 - 沒有人過半(split vote),逾時後 term 再加 1,重新選一次。
投票規則有兩條:
- 每台伺服器在同一個 term 最多投一票,先到先得。因為要過半才當選,所以一個 term 不可能出現兩個 leader。
- 投票者會比較 log 的新舊,自己的 log 比 candidate 新就拒絕投票(細節見後面的安全性一節)。
為了避免多台伺服器同時逾時、反覆平票,Raft 的 election timeout 是從一個固定區間隨機取值,論文舉的例子是 150 到 300 毫秒。多數情況下只會有一台先逾時,它贏得選舉並在其他人逾時前送出心跳。candidate 每次開始新選舉時也會重新隨機取一個逾時值。
論文也給了一條時間條件,系統要能穩定選出並維持 leader,需要滿足:
broadcastTime ≪ electionTimeout ≪ MTBFbroadcastTime 是一台伺服器平行送出 RPC 給所有伺服器並收到回應的平均時間,MTBF 是單台伺服器的平均故障間隔。論文估計 broadcastTime 依儲存技術約在 0.5 到 20 毫秒之間,因此 election timeout 大致落在 10 到 500 毫秒。這條不等式只影響可用性(能不能選出 leader),不影響安全性。
Log Replication:寫入何時算 committed
leader 選出來之後開始處理用戶端請求,每個請求帶一個要給狀態機執行的指令:
- leader 把指令附加到自己的 log,成為一筆新的 entry。每筆 entry 記錄指令、建立時的 term,以及它在 log 中的 index。
- leader 平行對其他伺服器送出
AppendEntries複製這筆 entry。 - 這筆 entry 被複製到過半數伺服器後,就算 committed。
- leader 把 committed 的 entry 套用到自己的狀態機,再把執行結果回給用戶端。
- leader 在之後的
AppendEntries(包含心跳)中帶上目前已知最大的 committed index,follower 得知後依 log 順序套用到自己的狀態機。
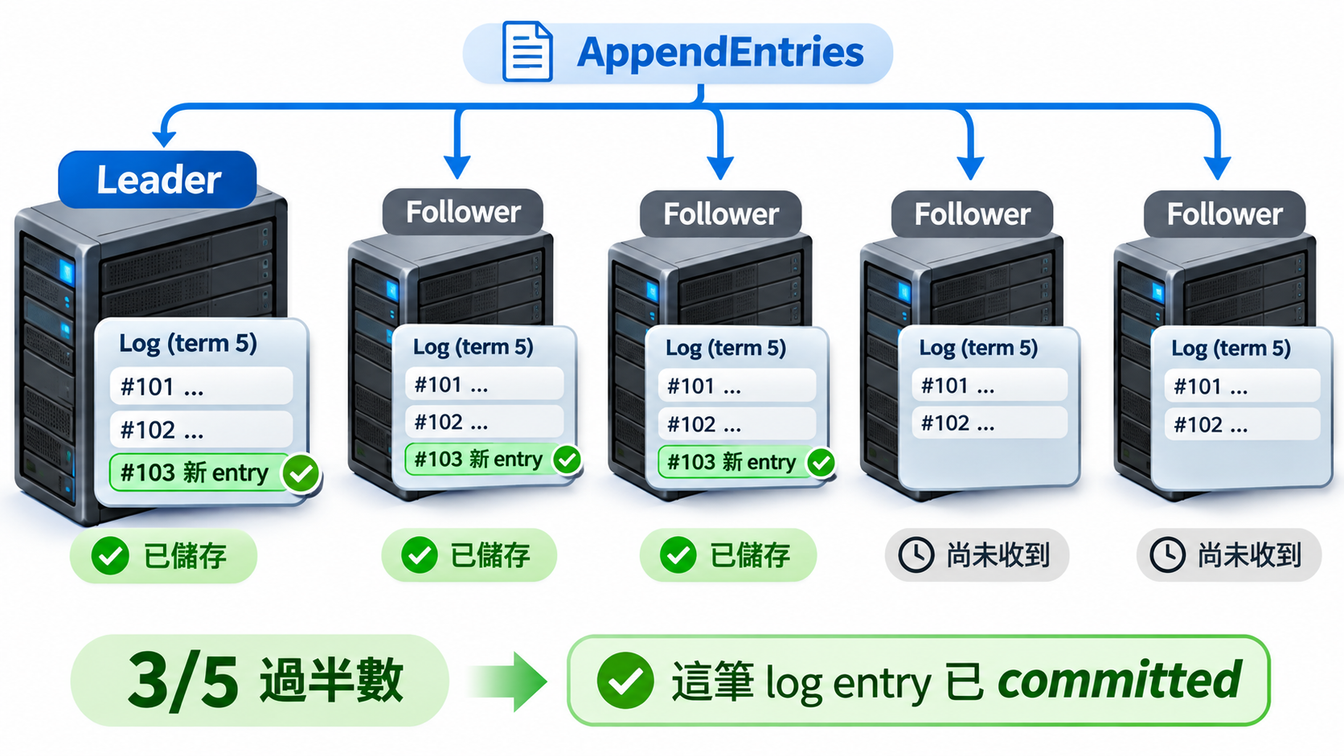
follower 當機、變慢或封包遺失時,leader 會持續重送 AppendEntries,直到所有 follower 都存下全部 entry。少數幾台慢不會拖住寫入,因為只要過半數就能 commit。
一致性檢查與 log 修復
leader 送出 AppendEntries 時,會附上新 entry 前一筆的 index 與 term。follower 在自己的 log 裡找不到同 index、同 term 的 entry,就拒絕這次請求。這個檢查撐起論文所說的 Log Matching 性質:兩份 log 中只要有一筆 entry 的 index 與 term 相同,那筆之前的所有 entry 也都相同。
leader 換人後,follower 的 log 可能缺資料、可能多出沒 committed 的資料,也可能兩者都有。Raft 的處理方式是以 leader 為準:
- leader 為每個 follower 維護一個
nextIndex,代表下一筆要送給它的 entry。 AppendEntries被拒絕時,leader 把nextIndex往前退再重試,直到找到兩邊一致的位置。- 從那個位置之後,follower 上衝突的 entry 會被刪除,換成 leader 的內容。
leader 自己的 log 只會附加,不會覆寫或刪除。
安全性:新 leader 為什麼不會弄丟已 committed 的資料
只有前面的機制還不夠。假設某台 follower 斷線期間 leader commit 了幾筆 entry,之後這台 follower 當選 leader,就可能把那些 entry 覆寫掉。Raft 用兩條額外限制堵住這個漏洞。
選舉限制:RequestVote 會帶上 candidate 的 log 資訊,投票者的 log 比 candidate 新就不投。新舊的比法是看最後一筆 entry:
- 最後一筆的 term 不同,term 較大的那份比較新。
- term 相同,log 較長的那份比較新。
已 committed 的 entry 一定存在於過半數伺服器上,而當選也需要過半數的票,兩個過半數必然有交集,所以拿得到過半數票的 candidate 一定持有所有已 committed 的 entry。
commit 限制:leader 只會用「複製到過半數」來判定自己目前這個 term 的 entry 是否 committed;前面 term 留下來的 entry,不能單靠數副本數就當作 committed。
等目前 term 有一筆 entry 被 commit,它之前的所有 entry 才因為 Log Matching 性質一併視為 committed。論文的 Figure 8 示範了少了這條限制時,一筆已經在過半數伺服器上的舊 entry 仍可能被後來的 leader 覆寫。
論文把 Raft 隨時成立的保證整理成五個性質:
| 性質 | 內容 |
|---|---|
| Election Safety | 一個 term 內最多選出一個 leader |
| Leader Append-Only | leader 不覆寫、不刪除自己 log 中的 entry,只附加 |
| Log Matching | 兩份 log 有一筆 entry 的 index 與 term 相同,則該筆之前的內容完全相同 |
| Leader Completeness | 某個 term 中 committed 的 entry,會出現在之後所有 term 的 leader 的 log 中 |
| State Machine Safety | 一台伺服器把某個 index 的 entry 套用到狀態機後,其他伺服器不會在同一個 index 套用不同的 entry |
叢集要幾台:quorum 與容錯對照
Raft 的每個決定(當選、commit)都需要過半數,也就是 quorum。etcd 與 Consul 的官方文件都以 (N/2)+1 表示 quorum 大小(Consul 文件的說明是至少需要 (N/2)+1 個成員),兩者在 1 到 7 台的數字相同:
| 叢集台數 | quorum | 可容忍故障台數 |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
| 6 | 4 | 2 |
| 7 | 4 | 3 |
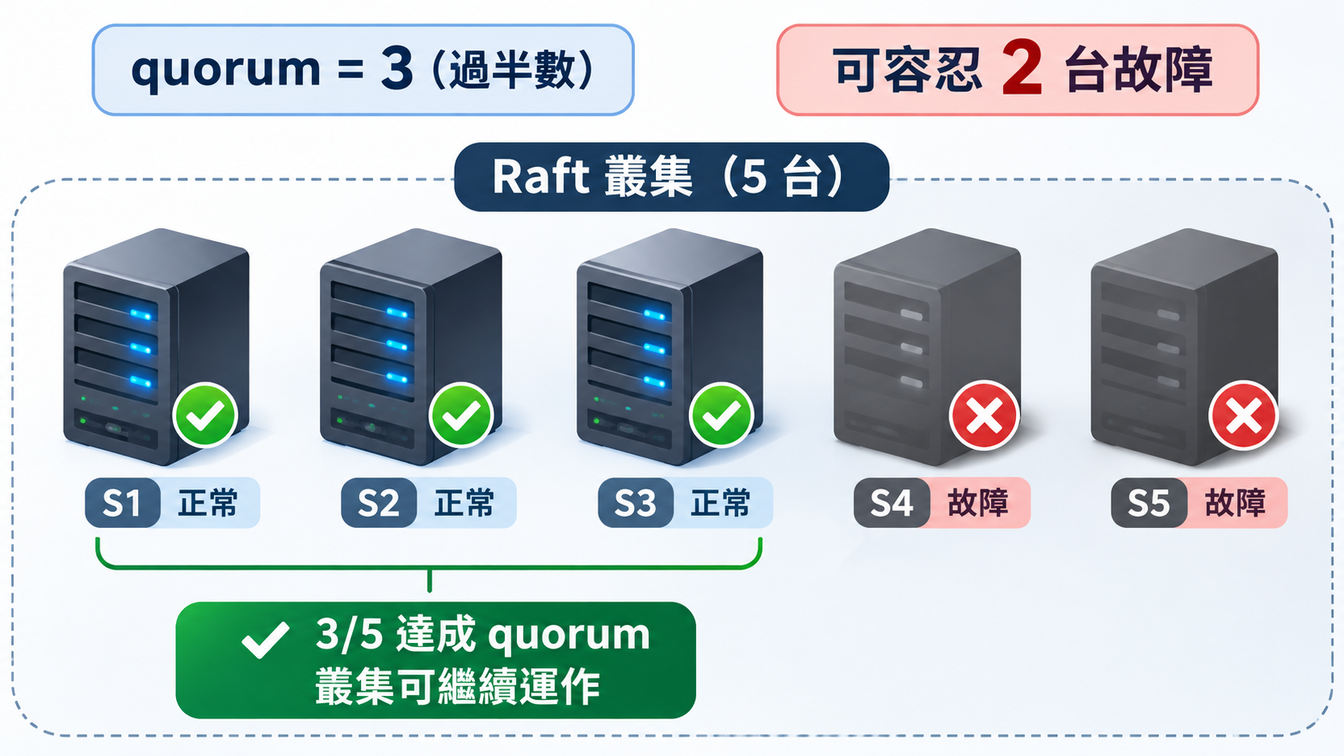
從表可以看出幾件事:
- 偶數台沒有額外好處:3 台加到 4 台,可容忍故障數仍是 1,quorum 卻從 2 變成 3。etcd 文件另外指出,奇數台在網路分割時能確保有一邊是多數。
- 2 台不能容錯:任何一台故障就失去 quorum。
- 台數不是越多越好:etcd 文件建議叢集不超過 7 台,理由是資料要複製到更多機器,寫入效能會下降。Consul 文件建議正式環境用 3 或 5 台。
失去 quorum 時叢集會停止接受寫入,但不會回傳錯誤結果。
成員變更、log 壓縮與讀取細節,可前往專文觀看。
單一 leader 的限制:Cloudflare 的事故與 Meerkat
Raft 的寫入都經過 leader,leader 出問題時要靠逾時偵測、再選舉才能恢復。選舉期間叢集無法寫入,這是設計上的已知取捨。
Cloudflare 公開過一次相關事故。依它的事後報告,2020 年 11 月 2 日一台網路交換器進入部分運作狀態。當時 etcd 叢集中的 node 1 連不到當時的 leader(node 3),但連得到 node 2;node 2 與 node 3 之間正常。
node 1 不斷發起選舉,node 2 因為還連得到 node 3 而把票投給 node 3,結果選不出 node 1 也連得到的 leader,叢集在交換器恢復前無法寫入。
交換器約 6 分鐘後自行恢復,但後續的資料庫主庫切換與副本重建,讓 API 與 dashboard 的影響持續了 6 小時 33 分鐘。Cloudflare 原本稱這是拜占庭故障,後記更正為社群指出它更接近遺漏型故障(omission fault)。
Cloudflare 在 2026 年 11 月 11 日的文章〈Choosing QuePaxa, an unusual consensus algorithm〉進一步整理了它對 leader-based 共識的看法,重點有三個:
- 故障偵測慢:在非同步網路中分不出「故障」和「網路慢」,逾時值設太短會誤判,設太長則偵測期間系統停擺。
- 選舉本身可能不穩定:短暫的網路中斷就可能讓 leader 看起來故障而觸發選舉。
- 多個提案者互相干擾:多方同時競爭時彼此阻擋,進度停滯。
因此它的實驗性全球共識服務 Meerkat 沒有採用 Raft,而是選了 2023 年發表的 QuePaxa。
依文章說明,QuePaxa 的 leader 只是擁有最高優先權的提案者,其他節點隨時也能提案。
用戶端會把提案送給所有 replica,非 leader 先等一小段 hedge timeout,讓 leader 有機會單獨完成決定;leader 故障時不需要先偵測、再選舉,其他提案者繼續推進即可。Cloudflare 對 Meerkat 的評估顯示,leader 故障時決定速率降到原本的約 65%,換掉 leader 後恢復,期間沒有完全停擺。
這件事要放在脈絡裡看:
- Cloudflare 自己在文中承認,QuePaxa 還沒有像 Raft 與 Paxos 那樣經過大量實戰檢驗;文中只給了相對變化,benchmarks 預告會在後續系列文章說明。
- Meerkat 的介紹文寫明它是實驗性服務、尚未部署到正式環境,目前做過最多 50 個 replica 的概念驗證;Cloudflare 認為它短期內適合用在很少寫入、但必須保持一致的控制平面資訊。
常見問題
Raft 和 Paxos 差在哪?
依 Raft 官方網站,兩者在容錯能力與效能上相當。論文的說法是 Raft 的結構不同:把問題拆成 leader election、log replication 與 safety 三塊,並採用較強的 leader(log 只從 leader 流向其他伺服器)。
網路分割時會不會出現兩個 leader 同時寫入?
舊 leader 被隔在少數那一邊時,它可能暫時還認為自己是 leader,但它湊不到過半數,任何新寫入都無法 commit。多數那一邊會以更大的 term 選出新 leader;分割恢復後,舊 leader 看到更大的 term 就退回 follower,它那些沒 committed 的 entry 會被新 leader 的 log 覆蓋。
參考資料與延伸閱讀
- The Raft Consensus Algorithm(官方網站)
- In Search of an Understandable Consensus Algorithm (Extended Version)
- etcd Frequently Asked Questions
- Consul:Consensus
- Cloudflare Blog:A Byzantine failure in the real world
- Cloudflare Blog:Introducing Meerkat: an experiment in global consensus
- Cloudflare Blog:Choosing QuePaxa, an unusual consensus algorithm

發佈留言