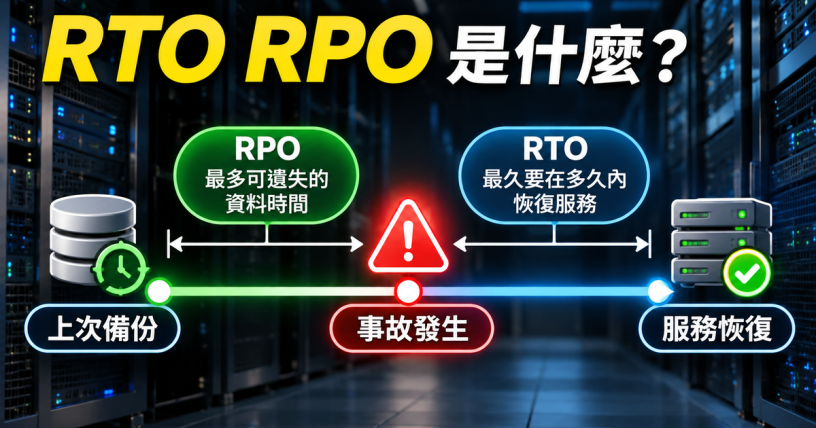
RTO RPO 是規劃災難復原(Disaster Recovery,DR)時要先訂的兩個目標值,都以時間表示:
- RTO(Recovery Time Objective,復原時間目標):服務中斷後,最久多久要恢復。
- RPO(Recovery Point Objective,復原點目標):最多能接受遺失多久的資料。
中文名稱採 Microsoft 繁體中文文件的譯法。兩個值都由組織自己依業務需求訂定,不是系統測出來的數字。
RTO 與 RPO 的定義
以事故發生的時間點為界,RPO 往前看,RTO 往後看。
| 比較項目 | RTO(復原時間目標) | RPO(復原點目標) |
|---|---|---|
| 回答的問題 | 服務可以停多久 | 資料可以掉多少 |
| 時間方向 | 事故發生之後,到服務恢復為止 | 事故發生之前,回推到最後一個資料復原點 |
| AWS 的定義 | 服務中斷到恢復之間,可接受的最長延遲 | 距離上一個資料復原點,可接受的最長時間 |
| NIST SP 800-34 的定義 | 系統元件可以處於復原階段的總時間,超過就會影響組織的任務或業務流程 | 中斷之後,資料必須復原到的時間點 |
| 主要取決於 | 接手環境準備到什麼程度、切換與還原要多久 | 備份或複寫的頻率 |
Google Cloud 的災難復原規劃文件補充了一點:RPO 衡量的只有時間,不是遺失資料的數量或品質。同一個「一小時」,對交易量不同的系統代表的資料筆數差很多。
用一個例子看兩者的差異
假設資料庫每天凌晨 2 點做一次完整備份,沒有其他複寫機制,下午 2 點主機故障,還原備份並重新上線花了 3 小時:
- 實際遺失的資料是凌晨 2 點到下午 2 點這 12 小時。
- 實際停機時間是 3 小時。
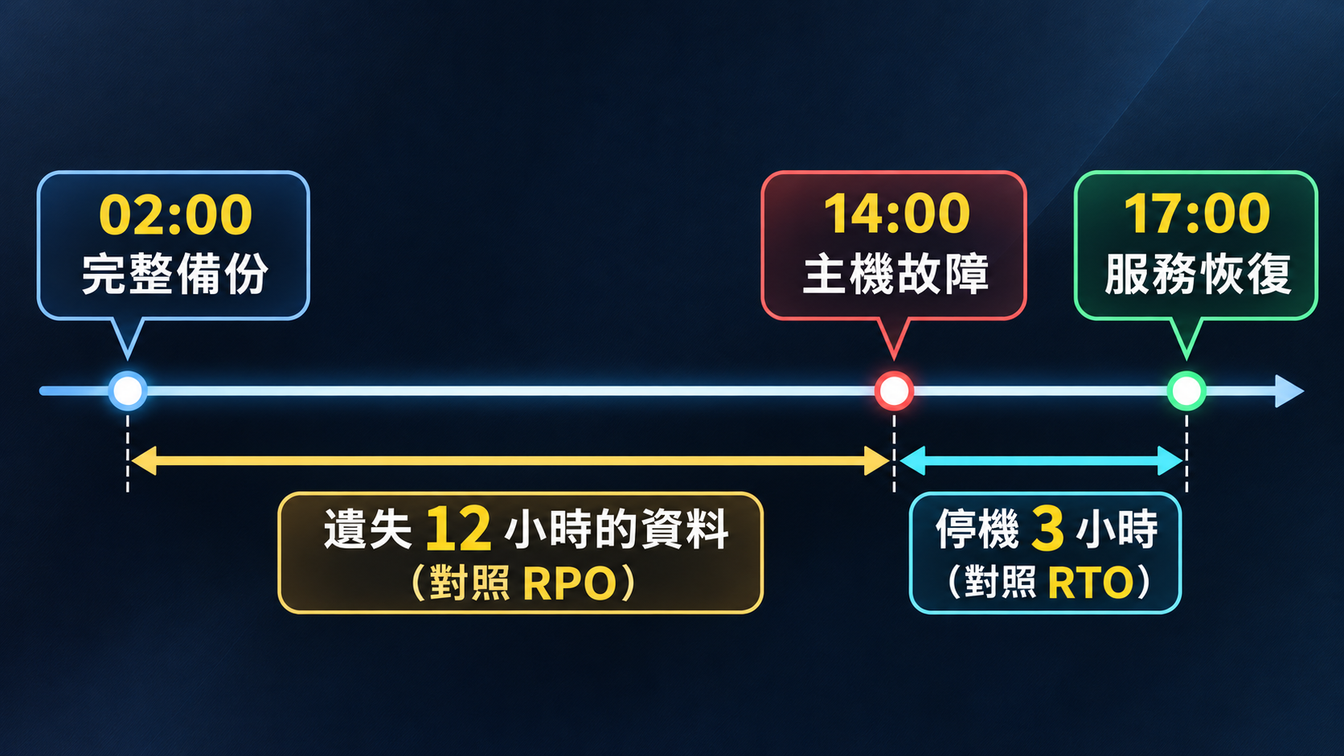
每天備份一次的做法,最壞情況是故障發生在下一次備份之前,遺失將近 24 小時的資料。所以這套做法能滿足的 RPO 是 24 小時;RPO 訂成 1 小時的話,備份或複寫的間隔就要縮到 1 小時以內。AWS 的災難復原白皮書也是這樣描述:備份執行的頻率決定了能達到的復原點。
RTO 則要看還原流程。同一份白皮書提到,災難發生後除了資料,基礎設施、設定和應用程式也要重新部署;沒有用基礎設施即程式碼(IaC)自動化的話,還原時間會拉長,可能超過 RTO。
RTO、RPO 和 MTTR、SLO 的關係
RTO 和 MTTR(Mean Time to Recovery,平均復原時間)量的都是中斷開始到恢復的這段時間。AWS 文件說明兩者的差別:MTTR 是一段期間內多次事件的平均值,RTO 是單一事件允許的目標上限。
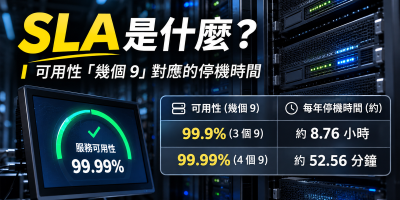
Google Cloud 的文件把 RTO 和 RPO 歸在 SLO(服務等級目標)之下:兩者都可以量測,應該當成 SLO 看待,RTO 通常也會寫進更大的服務等級協定(SLA)裡。SLA、SLO 的差別和可用性百分比的算法,見SLA 與幾個 9 的停機時間對照。
和備份、HA、災難復原的關係
備份頻率決定 RPO 能訂多小
要縮小 RPO,可以把備份改得更密,或改用持續複寫,讓另一份資料幾乎即時跟上。
持續複寫不能取代備份。AWS 白皮書指出,持續複寫的備份延遲最短,但遇到資料損毀或惡意刪除這類事件,保護效果不如時間點備份,除非另外搭配版本控管或時間點復原(point-in-time recovery)。同一份文件也寫明,資料損毀這類事故的復原時間一定大於零,復原點也一定落在發現問題之前的某個時間點。
HA 處理元件故障,災難復原處理一次性的大型事故
AWS 可靠性支柱把兩者分開:可用性衡量的是一段期間內,面對元件故障、負載尖峰或軟體錯誤時的平均表現;災難復原針對的是天災、大規模技術故障、攻擊或人為錯誤這類一次性事件,用 RTO 和 RPO 當目標。
高可用性(HA)架構靠多節點與故障切換消除單點故障(SPOF),讓單一節點故障時服務不中斷。AWS 白皮書的說法是,跨多個可用區域的高可用部署可以減輕單一資料中心失效的影響;要防範整個區域失效,就得另外規劃跨區域的災難復原策略,人為錯誤造成的資料遺失則要靠備份。Google Cloud 的文件也說 HA 和 DR 並不完全重疊,不過訂 RTO 與 RPO 時仍要把 HA 一起考慮。
兩者會互相影響。AWS 白皮書提到,一個已經跨多個可用區域部署的高可用工作負載,如果要防範的災難只到「單一實體資料中心失效」,災難復原可能只需要備份與還原這一層。
RTO、RPO 越小,成本越高
AWS 白皮書把雲端的災難復原策略分成四種,從成本與複雜度最低排到最高:
- 備份與還原(Backup and Restore):平常只做備份,出事後才重新部署並還原資料。
- Pilot Light:資料持續複寫到另一個區域,核心基礎設施已經備好,應用伺服器平常關閉,需要時才開啟並擴充。
- Warm Standby:另一個區域有一套縮小規模但功能完整、持續運作的環境,出事後只需要擴充容量。
- Multi-site Active/Active:多個區域同時對外服務,對多數災難可以把復原時間降到接近零,是最複雜、成本最高的做法。
即使採用 Active/Active,白皮書仍要求保留備份並定期測試還原。
Google Cloud 的文件說得直接:RTO 與 RPO 的值越小,應用程式的執行成本通常越高,管理也越複雜。
RTO 與 RPO 怎麼訂
AWS 白皮書的建議是從業務衝擊分析(Business Impact Analysis)開始:量化工作負載中斷對內外部客戶與業務的影響,藉此判斷服務需要多快恢復、能容忍遺失多少資料。訂目標時還要一起考慮中斷發生的機率與復原的成本。白皮書有一條附註:復原方案的成本如果高於故障或損失本身的成本,就不該採用,除非有法規要求之類的其他理由。
影響也可能隨時間變動。白皮書舉的例子是薪資系統:發薪日前中斷影響很大,剛發完薪水之後中斷影響就小得多。
目標訂好之後要靠演練驗證。白皮書要求定期評估並測試災難復原策略,備份策略也要包含還原測試。
參考資料與延伸閱讀
- AWS Well-Architected Framework 可靠性支柱:災難復原 (DR) 目標
- AWS 白皮書 Disaster Recovery of Workloads on AWS:Business Continuity Plan (BCP)
- AWS 白皮書 Disaster Recovery of Workloads on AWS:Disaster recovery options in the cloud
- NIST CSRC Glossary:Recovery Time Objective
- NIST CSRC Glossary:Recovery Point Objective
- Google Cloud:Disaster recovery planning guide
- Microsoft Azure Well-Architected Framework:定義可靠性目標的架構策略
- 延伸閱讀:HA 是什麼?高可用性系統架構與故障切換設計實務
- 延伸閱讀:SLA 是什麼:可用性 99.9%、99.99% 幾個 9 的停機時間對照與計算
- 延伸閱讀:單點故障(SPOF)是什麼:Single Point of Failure 的意思、常見位置與消除方法

發佈留言