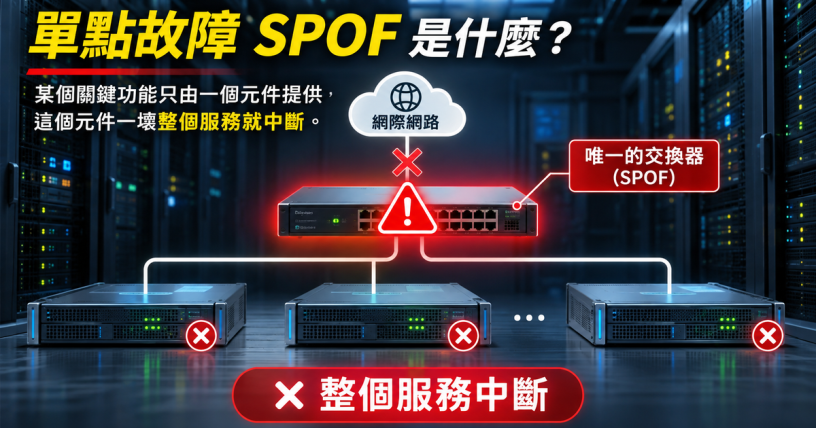
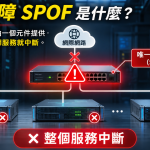
單點故障的英文是 Single Point of Failure,縮寫 SPOF。IBM PowerHA 文件的定義是:某個關鍵的叢集功能只由單一元件提供時,就存在單點故障。這個元件一壞,沒有其他元件可以接手,整個服務跟著中斷。
這篇是高可用性(HA)架構系列的名詞解釋,只講單點故障本身:它會出現在哪裡、怎麼找、消除要付出什麼代價。叢集怎麼偵測故障並自動接手,請看 HA 主文的故障切換流程。
單點故障會出現在哪些層級
單點不只是「只有一台主機」。從單一元件到整個地區,每一層都可能是單點。
| 層級 | 單點的樣子 | 文件怎麼說 |
|---|---|---|
| 節點內的元件 | 只有一張網路卡、一顆磁碟、一張磁碟控制卡 | IBM 把通訊介面、磁碟與磁碟控制卡各自列為要消除的單點 |
| 節點與應用程式 | 服務只跑在一台主機、一個執行個體上 | IBM 把節點和應用程式列為叢集裡要處理的單點 |
| 網路 | 節點之間或對外只有一條網路路徑 | IBM 把網路列為單點;AWS 要求自建的負載平衡器要在不同可用區域配置多個前端 |
| 機房或可用區域 | 正式環境只部署在單一可用區域 | AWS 把這種部署列為常見的反面做法 |
| 地區 | 關鍵資料庫只放在一個區域 | Google Cloud 指出,唯一的可用區或區域中斷時,整個系統就是全域中斷 |
以一條常見的網站請求路徑來看,使用者的請求會依序經過 DNS、負載平衡器、應用伺服器和資料庫,任何一層只有一個元件,那一層就是單點:
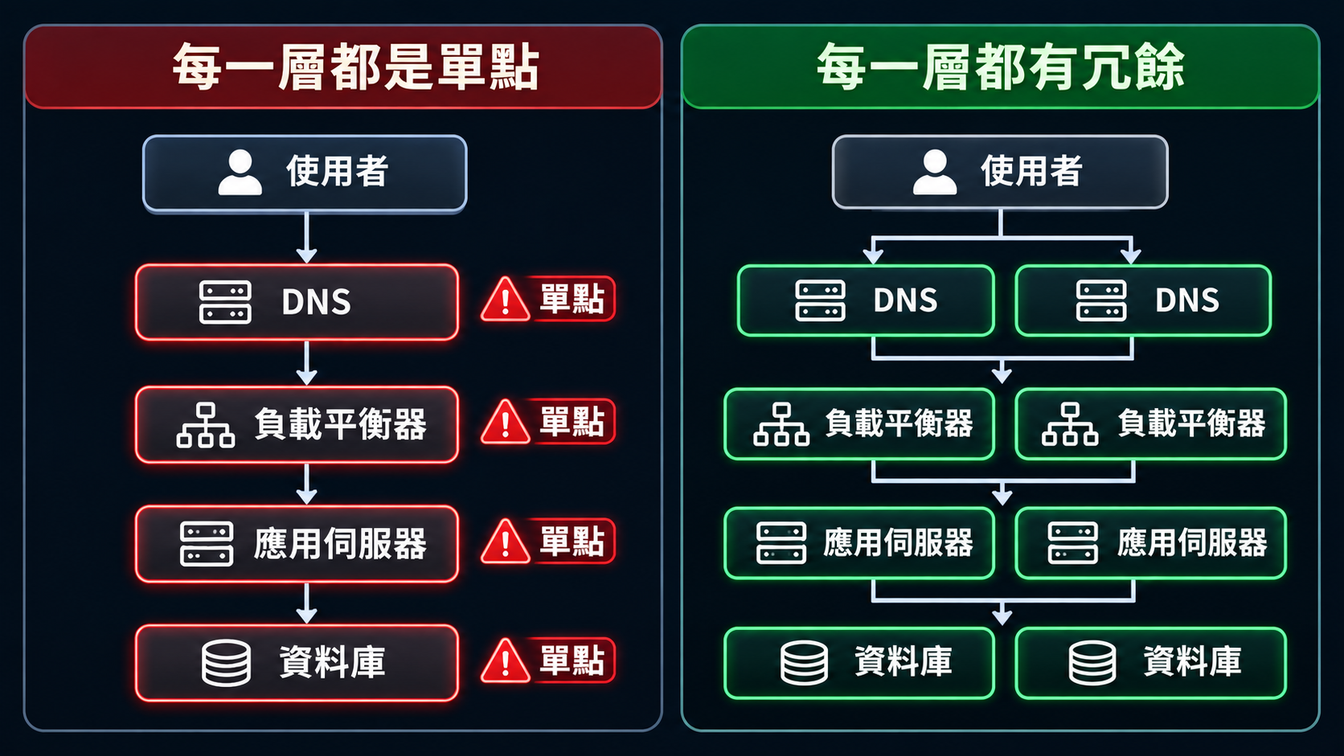
AWS 可靠性支柱把「避免單點故障」稱為服務設計的基本原則,而且特別註明包含底層的實體基礎設施。同一份文件的開頭也提到,傳統地端環境不容易做到可靠,原因之一就是單點故障。
元件之外,相依的服務也會是單點。Microsoft 的 Azure Well-Architected 文件把相依性分成兩種:內部相依是工作負載範圍內的元件,例如 API 或金鑰管理服務;外部相依是範圍外的元件,例如身分驗證服務或第三方服務。文件裡的電商網站範例中,身分驗證服務中斷的後果是整個工作負載中斷,而且只能等供應商修復。
怎麼找出單點故障
Microsoft 的做法是失敗模式分析(Failure Mode Analysis,FMA),步驟大致是:
- 拆解工作負載:列出支撐服務的元件類型,包含入口控制、網路、運算、資料、儲存、驗證與金鑰管理這類支援服務。
- 把流程疊上去:找出每條使用者流程或系統流程實際用到哪些元件,並依流程的重要性判斷元件的重要性。
- 盤點相依性:列出內部與外部相依,並記下各自的可用性 SLA、擴充上限等可靠性資料。Microsoft 文件直接寫明,盤點相依性就是為了做單點故障分析。
- 逐一評估失敗模式:對關鍵流程裡的每個元件,檢查它在各種失敗模式下會怎樣。文件列的失敗模式有區域中斷、可用區域中斷、服務中斷、DDoS 等惡意攻擊、設定錯誤、操作人員失誤、計畫性維護、元件過載。
- 分類強相依與弱相依:強相依對應用程式的功能與可用性影響重大,缺了它應用程式無法運作;弱相依失效可能只影響特定功能。強相依的可用性與復原目標,應該和應用程式本身的目標一致。
AWS 文件有個相近的說法叫硬相依(hard dependency):被依賴的系統一中斷,呼叫它的系統也跟著中斷。硬相依串得越多,整體可用性越低,算法見SLA 與幾個 9 的可用性計算。
Microsoft 文件也提醒,這份分析一開始多半是紙上推演,要定期檢討,並用混沌測試和實際事故的經驗修正。
怎麼消除單點故障
做法是冗餘(Redundancy)。Microsoft 對冗餘的定義是:同一個工作負載元件部署多個相同的執行個體,讓只影響單一資源的問題不會拖垮整個系統。
Google Cloud 的架構文件列了三個要點:
- 關鍵元件都要有複本:系統裡每個關鍵元件都要跨多台機器、多個可用區與多個區域複製。文件舉的反例是關鍵資料庫只放在一個區域,或中繼資料伺服器只部署在單一可用區。
- 自動容錯移轉:可用區或區域中斷時,系統要能自動切換,服務才不會中斷。
- 負載平衡加健康檢查:用負載平衡器把流量導到健康的後端,並定期模擬故障,驗證複製與切換真的有效。
AWS 的建議是所有正式環境的工作負載至少部署在同一個區域的兩個可用區域,運算資源和資料都要分散;對可用性要求極高的系統,才需要跨兩個以上的區域。
有複本還不夠,剩下的節點要撐得住。Microsoft 文件舉的例子:流量分給兩個節點,各自跑在 60% 的使用率,其中一個故障時,剩下的那個沒辦法用 120% 運作。備用容量要足以撐過故障節點復原所需的整段時間。
冗餘本身也要保護。Microsoft 文件指出,誤刪資料庫、DNS 區域或流量路由層,會讓冗餘失效,可以替這些資源加上防刪除鎖定來降低人為失誤的影響。
冗餘的代價:不是每個單點都要消除
Microsoft 文件列了冗餘的幾項取捨:
- 成本:冗餘越多,成本越高,尤其是用超額佈建當作備援策略的時候。
- 效能:資源跨可用區域或跨地點部署後,複本之間的流量要走延遲較高的連線。
- 複雜度:同一個工作負載裡,不同流程的可靠性需求不同,各自設計冗餘會讓整體設計變複雜。
所以要看發生機率。Microsoft 的失敗模式分析文件寫明,有些失敗模式非常少見,例如多個可用區域或多個區域同時中斷,替它們規劃冗餘以外的緩解措施並不划算;分析結果要依嚴重性與發生機率排序,把資源放在常見又嚴重的項目上。AWS 也把「多可用區域就能滿足需求,卻做成多區域架構」列為反面做法。
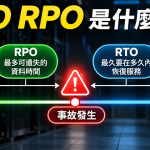
無法消除或決定接受的單點,要改訂出事之後的復原目標,也就是多久要恢復、能接受遺失多少資料,見RTO 與 RPO 的定義與差異。
另一條路是讓服務降級運作。Microsoft 文件的例子是電商網站的推薦引擎故障時,顧客仍然可以搜尋商品並完成結帳;元件還是單點,但它失效時不會拖垮整條流程。
參考資料與延伸閱讀
- IBM PowerHA SystemMirror:Eliminating single points of failure in a PowerHA SystemMirror cluster
- AWS Well-Architected Framework 可靠性支柱:REL10-BP01 Deploy the workload to multiple locations
- Google Cloud Well-Architected Framework:Build highly available systems through resource redundancy
- Microsoft Azure Well-Architected Framework:Architecture strategies for performing failure mode analysis
- Microsoft Azure Well-Architected Framework:Architecture strategies for designing for redundancy
- 延伸閱讀:HA 是什麼?高可用性系統架構與故障切換設計實務
- 延伸閱讀:SLA 是什麼:可用性 99.9%、99.99% 幾個 9 的停機時間對照與計算
- 延伸閱讀:RTO RPO 是什麼:復原時間目標與復原點目標的定義、差異與備份頻率關係

發佈留言