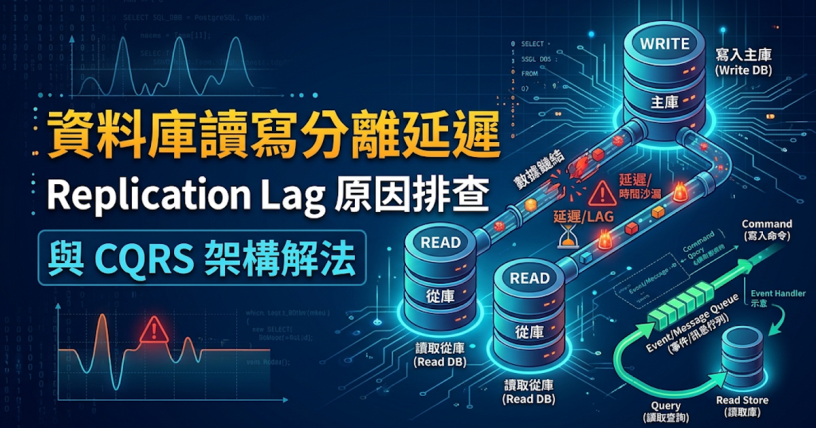
在現代高併發系統中,導入資料庫讀寫分離是分散資料庫負載的常見手段,然而實施讀寫分離延遲往往會帶來「寫入後立即讀取卻抓不到最新狀態」的典型一致性痛點。這種主從同步的秒級甚至分鐘級落差,會直接導致前端畫面資料無法即時更新。關於網頁底層的傳輸語意與狀態管理基礎,可先參考 淺談 HTTP 請求方法 (HTTP Request Methods):GET、POST、PUT、DELETE 基礎概念與 Fetch 入門。本文將解析 Replication Lag 的根本原因、監控指標排查,並提供從應用層到架構級的實務解決方案。
如果您正在尋找立即可用的主從路由切換邏輯或架構對照,可直接跳至 一、核心機制與規格對照 檢視。
一、 核心機制與規格對照
在處理讀寫分離延遲時,首先必須掌握底層資料庫非同步複製的運作機制與各項架構解法的效能取捨。以下為常見主從複製延遲解法與架構模式的 3 欄規格對照表:
| 架構模式/技術方案 | 核心運作原理 | 適用情境與效能取捨 |
|---|---|---|
| 強制讀主庫 (Read-from-Master) | 針對關鍵寫入後的短期讀取請求,強制將連線導向 Master 主庫。 | 確保強一致性;會增加主庫讀取負載,適合寫後即讀的敏感業務。 |
| CQRS 架構解法 | 將命令(寫入)與查詢(讀取)模型徹底解耦,透過事件驅動同步。 | 讀寫比例懸殊的大型系統;架構複雜度高,讀取端為最終一致性,寫後即讀仍需另外處理。 |
| Redis 快取搭配版本號(write-through 寫法) | 寫入資料庫時同步更新快取與版本號,讀取時優先比對版本。 | 高併發讀取場景;需額外維護快取失效與版本一致性邏輯。 |
針對關鍵寫入操作後需強制讀取主庫的簡易應用層路由實作範例(Node.js / JavaScript 虛擬碼):
// 根據請求意圖與上下文動態決定連線池
function getDatabaseConnection(req) {
    // 若為寫入請求,或使用者剛完成寫入(例如帶有 session 標記)
    if (req.method !== 'GET' || req.session.forceMasterRead) {
        return masterPool.getConnection();
    }
    // 一般讀取請求導向從庫(副本,replica)
    return replicaPool.getConnection();
}
二、 關鍵機制與跨情境細部拆解
1. 主從複製延遲成因與監控指標排查
MySQL 的複寫預設為非同步:主庫(source)寫入 Binlog(二進位日誌),由 Binlog Dump 執行緒送給從庫(replica),從庫的 I/O(receiver)執行緒接收後寫入 Relay Log(中繼日誌),再由 SQL(applier)執行緒重放(Replay)。MySQL 8.4 預設啟用多執行緒重放(replica_parallel_workers 預設 4,由一個 coordinator 執行緒分派交易給多個 worker),但遇到大批量資料異動(Bulk Insert/Update)或耗時的 DDL 時,重放速度仍可能跟不上,造成 Relay Log 堆積。
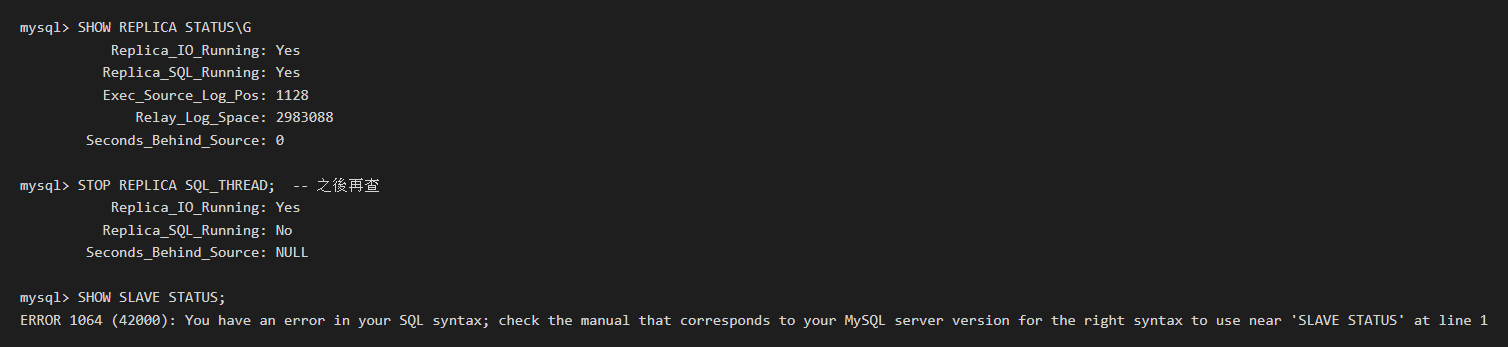
開發與維運團隊可透過 SHOW REPLICA STATUS 的 Seconds_Behind_Source 欄位(MySQL 8.0.22 以前叫 Seconds_Behind_Master)評估延遲狀態:
- 指標原理:從庫正在處理事件時,顯示從庫目前時間與該事件在主庫記錄的原始時間戳記之差;沒有事件正在處理時為
0。 - 排查盲點:在 MySQL 8.4,applier 執行緒沒有執行,或 applier 已讀完 Relay Log 且 receiver 執行緒沒有執行時,這個欄位是
NULL;receiver 仍在執行但 Relay Log 已讀完時則是0。網路慢時 receiver 本身可能已落後主庫,這個欄位卻常顯示0,官方手冊說明它只在網路快速時才有參考價值。因此要同時檢查Replica_IO_Running與Replica_SQL_Running(舊名Slave_IO_Running、Slave_SQL_Running),並檢視Relay_Log_Space(所有 Relay Log 檔案的總大小)。
2. 應用層強制讀主庫 (Read-from-Master) 策略
為了根治關鍵業務流程中的資料不一致,最直接的做法是在應用層實施智慧路由。當使用者執行訂單建立或帳戶修改等 POST/PUT 請求後,系統會在當前使用者的 Session 或 Token 中寫入一個暫時性的時間戳記(例如 last_write_timestamp)。
在隨後的短時間內(例如 5 秒內),該使用者發動的所有 GET 請求一律繞過從庫,強制導向主庫讀取。一旦時間戳記逾期,路由則自動恢復為負載平衡的從庫讀取模式,有效在主庫負載與讀寫分離延遲之間取得平衡。
3. 引入 CQRS (Command Query Responsibility Segregation) 架構
當業務規模擴大,單一關聯式資料庫無法負荷時,可導入 CQRS 架構。CQRS 的核心是用不同的模型處理更新與讀取;Martin Fowler 也提醒,對多數系統而言 CQRS 會增加有風險的複雜度。CQRS 將系統明確劃分為兩大職責:
- Command 端(寫入模型):專注於事務處理、業務邏輯驗證與資料完整性,通常寫入高度正規化的主資料庫。
- Query 端(讀取模型):專注於高效能查詢與複雜檢索,資料透過訊息佇列(如 Kafka、RabbitMQ)非同步同步至寬表或 NoSQL 資料庫(如 Elasticsearch、MongoDB)。
讀寫資料庫分開後,兩端可以各自擴充,也能選用不同的儲存技術。常見做法是寫入模型更新資料庫時發布事件,讀取模型據此更新資料;資料庫與訊息佇列通常無法放進同一個分散式交易,可用 Transactional Outbox 模式把狀態變更與事件一起保存。要注意讀取端仍是最終一致性:讀取資料庫不一定立刻反映最新變更,寫後即讀的頁面仍需搭配前面的強制讀主庫或版本號比對。
4. 高併發下的 Redis 版本號快取策略
標準的 Cache-Aside 模式在寫入時讓快取失效、下次讀取再重新載入,兩次之間讀者可能遇到快取未命中或短暫讀到舊資料;寫入時同時更新資料庫與快取的是 write-through 寫法,寫入成功後就能讀到新值。下面的做法屬於後者,在 Redis 快取中搭配版本號(Version / Timestamp)處理讀寫分離延遲:
- 當應用程式寫入資料時,同時在資料庫欄位更新
version = version + 1,並將最新資料與版號寫入 Redis。 - 當讀取請求到達時,應用程式先從 Redis 取得資料與版號。
- 若必須查詢資料庫從庫,則比對從庫資料的版號是否大於或等於 Redis 中的版號;若從庫版號落後,則直接回傳 Redis 中的最新快取或強制轉向主庫,確保使用者不會讀到舊資料。
三、 常見問題與排錯(Q&A)
1. 為什麼實施資料庫讀寫分離後,會發生寫入資料後立即讀取卻抓不到最新狀態的 Replication Lag 現象?
- 問題原因:MySQL 複寫預設為非同步,主庫提交後不會等待從庫,而從庫接收並重放 Binlog 需要時間。在此非同步時間差內進行讀取,自然會從從庫讀取到舊的歷史狀態。
- 解法:在關鍵寫入後短時間內採用強制讀主庫策略。半同步複製只保證至少一台從庫已收到並記錄事件,不要求從庫已執行完畢,所以它能降低主庫故障時遺失交易的風險,但不能保證從從庫讀到最新資料。
2. 在 MySQL 主從複寫中,如何透過監控 Seconds_Behind_Source(舊名 Seconds_Behind_Master)指標來評估主從同步延遲?
- 問題原因:
Seconds_Behind_Source量的是 applier 與 receiver 執行緒之間的時間差;網路慢時 receiver 落後主庫也可能顯示0,主從時鐘差異改變(包含 NTP 校時)也會讓數值不可靠,多執行緒重放時則以Exec_Source_Log_Pos為準,不一定反映最近提交的交易。 - 解法:依序檢查並建立自動化監控:
- 在從庫執行下列指令查看複寫狀態(MySQL 8.0.22 起取代
SHOW SLAVE STATUS,8.4 已移除舊語法):SHOW REPLICA STATUS\G - 同時檢查輸出中的
Replica_IO_Running、Replica_SQL_Running與Relay_Log_Space,不要只看Seconds_Behind_Source。 - 在應用端建立自動化健康檢查機制,當延遲超過設定閾值時自動降級,將讀取流量切回主庫。
- 在從庫執行下列指令查看複寫狀態(MySQL 8.0.22 起取代
3. 當使用者執行關鍵寫入操作後,如何在 API 層實施強制讀主庫 (Read-from-Master) 路由策略?
- 問題原因:全域強制讀主庫會失去讀寫分離的意義,導致主庫過載。
- 解法:在 API 中介層(Middleware)檢測請求方法與 User Session。若為寫入動作完成後的短暫窗口期(如 3 秒內),動態切換資料庫連線池至 Master;其餘一般讀取則維持走 Slave。
4. 如何透過 CQRS 架構將資料讀寫模型徹底解耦?
- 問題原因:傳統架構中單一資料表同時承擔高頻寫入與複雜多維度查詢,導致鎖競爭劇烈與主從延遲惡化。
- 解法:將系統拆分為 Command 與 Query 兩條獨立管線,利用事件總線(Event Bus)非同步更新唯讀端,讓查詢負載落在獨立的讀取資料庫。唯讀端是最終一致,消費事件的程式要能承受重複投遞(冪等),需要寫後即讀的畫面仍要另外處理。
5. 在高併發場景下,如何利用 Redis 快取搭配版本號或時間戳記來解決讀寫分離延遲?
- 問題原因:直接查詢從庫容易遇到落後資料,而全部走快取又面臨快取擊穿與一致性維護難題。
- 解法:寫入時同步更新 Redis 的資料與遞增版號;讀取時進行版號校驗,若從庫版本落後則強制使用 Redis 快取內容,保證讀取一致性。
6. 半同步複製 (Semi-synchronous Replication) 與群組複製 (Group Replication) 對於降低讀寫分離延遲的效能取捨為何?
- 問題原因:非同步複製延遲無法預期,但過度追求同步會顯著降低寫入吞吐量。
- 解法:半同步複製讓主庫等到至少一台從庫收到並記錄事件(需要的台數可設定)才提交,能降低資料遺失風險但會增加提交延遲,且不保證從庫已執行該交易。Group Replication 的群組通訊核心是 Paxos 演算法的實作,讀取一致性由
group_replication_consistency決定(MySQL 8.4 預設BEFORE_ON_PRIMARY_FAILOVER):需要寫後即讀時,可在個別交易設定AFTER(寫入交易等其他成員都套用後才完成)或BEFORE(唯讀交易先等之前的交易套用完),代價是這些交易的延遲增加。
參考資料與延伸閱讀
- MySQL 8.4 Reference Manual – Replication
- MySQL 8.4 Reference Manual – Replication Threads
- MySQL 8.4 Reference Manual – SHOW REPLICA STATUS Statement
- MySQL 8.4 Reference Manual – Semisynchronous Replication
- MySQL 8.4 Reference Manual – Configuring Transaction Consistency Guarantees
- Martin Fowler – CQRS
- Microsoft Azure Architecture Center – CQRS pattern
- Microsoft Azure Architecture Center – Cache-Aside pattern
- 資料庫類型選型規格:RDBMS、NoSQL 與圖形資料庫特性比較

發佈留言