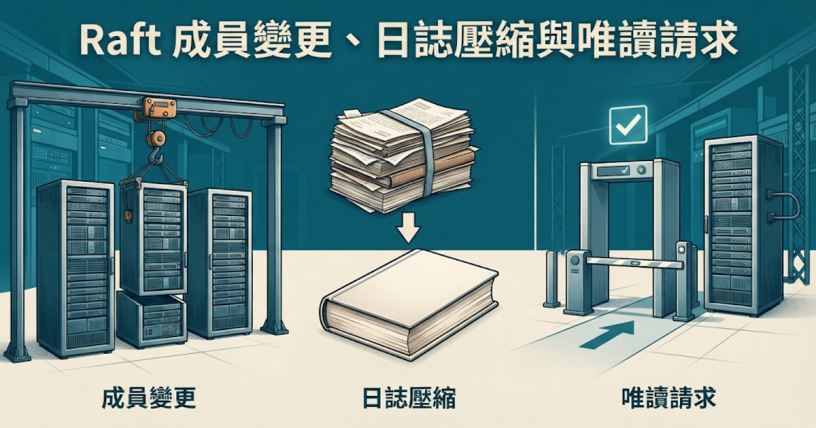
Raft 成員變更、日誌壓縮與唯讀請求,是把核心演算法做成實際系統時一定會碰到的三件事。先給結論:
- 成員變更:不能讓每台伺服器各自直接從舊設定換成新設定,否則可能同時出現兩組過半數。做法有兩種:一次只增減一台(博士論文的單節點變更),或先經過 joint consensus 過渡設定(原始論文)。
- 日誌壓縮:每台伺服器各自把已 committed 的部分寫成 snapshot,再刪掉被涵蓋的 log;落後太多的 follower 由 leader 用
InstallSnapshot補上。 - 唯讀請求:可以不寫進 log,但 leader 讀之前必須先確認自己沒被取代(ReadIndex,與過半數交換心跳),或改靠時鐘租約(lease read),後者的安全性要靠時間假設。
Leader Election、Log Replication 與 quorum 的基本概念請先看Raft 共識演算法主篇。本文以 Raft 原始論文與 Diego Ongaro 的博士論文為主,etcd 的文件與 Raft 函式庫當作實作對照。
Raft 成員變更:一次只動一台,或先過 joint consensus
成員變更指叢集的伺服器名單(論文稱為 configuration,設定)改變,例如換掉壞機器、增加或減少複製份數。
為什麼不能直接切換
各台伺服器不可能在同一瞬間改用新設定。如果各自直接切換,中間會出現舊設定的過半數與新設定的過半數互不重疊,同一個 term 就可能選出兩個 leader。論文的 Figure 10 用三台擴成五台說明這個情況。
用數字看更清楚:三台的過半數是 2 台,五台的過半數是 3 台,2 加 3 剛好等於 5,所以 S1、S2 與 S3、S4、S5 可以各自湊成過半數且完全不重疊。三台變四台時,2 加 3 等於 5,大於 4 台,兩組過半數一定有交集。
下面這支 Node.js 腳本把舊、新設定各自所有的過半數組合列出來,逐一檢查有沒有不重疊的組合:
// 列舉舊、新設定各自所有「過半數」子集合,檢查任兩組是否一定有交集
function majorities(servers) {
  const need = Math.floor(servers.length / 2) + 1;
  const result = [];
  for (let mask = 1; mask < 1 << servers.length; mask++) {
    const subset = servers.filter((_, i) => mask & (1 << i));
    if (subset.length >= need) result.push(subset);
  }
  return result;
}

function checkOverlap(oldCfg, newCfg) {
  for (const a of majorities(oldCfg)) {
    for (const b of majorities(newCfg)) {
      if (!a.some((s) => b.includes(s))) return { ok: false, a, b };
    }
  }
  return { ok: true };
}

const S = (n) => Array.from({ length: n }, (_, i) => `S${i + 1}`);
const cases = [
  ['3 台 → 4 台(加 1 台)', 3, 4],
  ['4 台 → 3 台(減 1 台)', 4, 3],
  ['4 台 → 5 台(加 1 台)', 4, 5],
  ['5 台 → 4 台(減 1 台)', 5, 4],
  ['3 台 → 5 台(一次加 2 台)', 3, 5],
];

for (const [label, from, to] of cases) {
  const r = checkOverlap(S(from), S(to));
  console.log(
    r.ok
      ? `${label}:任兩組過半數一定有交集`
      : `${label}:可能出現不重疊的兩組過半數,例如 [${r.a}] 與 [${r.b}]`
  );
}
以 Node.js v22 執行的輸出如下:
3 台 → 4 台(加 1 台):任兩組過半數一定有交集
4 台 → 3 台(減 1 台):任兩組過半數一定有交集
4 台 → 5 台(加 1 台):任兩組過半數一定有交集
5 台 → 4 台(減 1 台):任兩組過半數一定有交集
3 台 → 5 台(一次加 2 台):可能出現不重疊的兩組過半數,例如 [S1,S2] 與 [S3,S4,S5]
只增減一台時,新舊設定的過半數一定重疊;一次改兩台以上就可能不重疊。這正是下面兩種做法的分界。
做法一:單節點變更
博士論文提出的較簡單做法,是限制每次只能新增或移除一台伺服器;要做大幅度的調整,就拆成一連串的單節點變更。因為過半數一定重疊,新設定可以直接生效,不需要過渡階段。
流程如下:
- leader 收到變更請求後,把新設定(Cnew)當成一筆特殊的 log entry,用一般的複製機制送出去。
- 每台伺服器只要把這筆設定寫進自己的 log,就開始用它,不必等它 committed;判斷 Cnew 這筆 entry 有沒有過半數,也用新設定來算。
- Cnew entry committed 後,變更才算完成:leader 可以回報成功,被移除的伺服器可以關機,下一次變更也可以開始。
在上一筆設定 committed 之前,不可以開始下一筆,否則重疊的變更可能回到前面那種不安全的情況。另外,這筆設定 entry 有可能因為換 leader 被丟掉,所以伺服器要能退回 log 裡更早的那一份設定。
做法二:joint consensus
原始論文的做法適用於一次改變任意台數。它分成兩個階段:叢集先切換到一個同時包含新舊設定的過渡設定,論文稱為 joint consensus(Cold,new);這筆過渡設定 committed 之後,再切換到新設定(Cnew)。
過渡期間的規則有三條:
- log entry 要複製給新舊兩個設定裡的所有伺服器。
- 新舊設定裡的任何一台伺服器都可以當 leader。
- 選舉與 commit 都要分別取得舊設定與新設定各自的過半數。博士論文舉的例子:從 3 台換成 9 台時,需要舊設定 3 台中的 2 台,以及新設定 9 台中的 5 台。
過渡設定 committed 之後,舊設定與新設定都不能單獨做決定,而且只有持有這筆過渡設定的伺服器才可能當選 leader,所以這時 leader 可以放心送出 Cnew。Cnew 依新設定的過半數 committed 之後,舊設定就不再有作用,不在新設定裡的伺服器可以關掉。整個過程中,沒有任何時間點讓新舊設定各自獨立決定,叢集也可以持續處理用戶端請求。
兩種做法怎麼選
| 項目 | 單節點變更 | joint consensus |
|---|---|---|
| 一次可改幾台 | 1 台 | 任意台數 |
| 過渡階段 | 沒有,新設定直接生效 | 有,先 Cold,new 再 Cnew |
| 判斷過半數的方式 | 只看目前這份設定 | 新舊兩份設定要各自過半數 |
| 實作複雜度 | 較簡單 | 較複雜,投票與 commit 的判斷都要改 |
博士論文把 joint consensus 當作為了完整性才保留的原始做法,並明講知道單節點做法之後,建議採用單節點變更,理由是實務系統用一連串單節點變更就能達到想要的任何設定。
成員變更的三個實務問題
論文與博士論文另外處理三個會影響可用性的狀況:
- 新伺服器的 log 是空的:直接加進來的話,要追上進度需要一段時間,期間可能無法 commit 新的 entry。做法是先讓新伺服器以不投票成員的身分加入,leader 把 log 複製給它,但不把它算進過半數;追上之後才進行設定變更。
- leader 不在新設定裡:leader 要等 Cnew committed 之後才退回 follower。在這段期間,它管理的是一個不含自己的叢集:照常複製 entry,但不把自己算進過半數。
- 被移除的伺服器擾亂叢集:被移除的伺服器收不到心跳,會逾時並發起選舉,帶著更大的 term 逼目前的 leader 退位。解法是讓伺服器在距離上次聽到現任 leader 的時間還沒超過最小 election timeout 時,收到
RequestVote就不更新 term、也不投票。
etcd 與它的 Raft 函式庫怎麼做
etcd 的官方文件(v3.6)說明,叢集成員的變更必須依序進行:從 3 台增加到 5 台要做兩次新增,從 5 台減少到 3 台要做兩次移除。文件也建議加入新成員時,先以 learner(不投票成員)身分加入,等它的 Raft log 追上 leader 之後再升級為投票成員;還沒追上就要求升級,請求會失敗。
etcd 使用的 Raft 函式庫(etcd-io/raft)在設定變更的訊息中,同時支援一次一台的簡單做法與 joint consensus。預設的轉換模式會在能用簡單做法時就用,其餘情況才使用 joint consensus。
補充說明:這個函式庫的 README 指出,它的設定變更是在 entry 被「套用」(applied)到狀態機時才生效,而不是像論文那樣寫進 log 就生效;README 的說法是因為新舊設定保證有重疊,所以在安全性上等價。要在自己的系統接這個函式庫時,這個差異需要注意。
日誌壓縮:snapshot 與 InstallSnapshot
Raft 的 log 會隨著用戶端請求一直變長。論文指出實際系統不能讓它無限成長:log 越長,佔用的空間越多,重新啟動時重播也越花時間,最後會影響可用性。
snapshot 裡面有什麼
快照(snapshot)是最簡單的做法:把狀態機目前的完整狀態寫到穩定儲存,然後丟棄到那個位置為止的整段 log。論文提到 Chubby 與 ZooKeeper 也用快照。
快照除了狀態機的狀態,還附帶三項中繼資料:
- last included index:快照取代的最後一筆 log entry 的 index。
- last included term:那筆 entry 的 term。這兩項是為了讓快照之後第一筆 entry 仍能通過
AppendEntries的一致性檢查,因為那筆 entry 需要前一筆的 index 與 term。 - 最新的叢集設定:截至 last included index 的設定,讓成員變更在快照之後仍然成立。
伺服器寫完快照後,就可以刪除到 last included index 為止的所有 log entry,以及更早的舊快照。
每台伺服器各自做快照
每台伺服器獨立做快照,而且只涵蓋已 committed 的 entry。這稍微偏離了 Raft 的強 leader 原則,因為 follower 不需要 leader 同意就能做快照。論文認為這樣合理:做快照時共識已經達成,不會有決定互相衝突,資料仍然只從 leader 流向 follower,只是 follower 可以自己整理手上的資料。
論文也考慮過只讓 leader 做快照、再送給每個 follower 的做法,但有兩個缺點:把快照送給每個 follower 會浪費網路頻寬並拖慢快照;leader 的實作也更複雜,因為它得一邊送快照、一邊繼續複製新 entry,不能擋住新的用戶端請求。
InstallSnapshot:補上落後太多的 follower
多數時候 follower 跟得上 leader,不需要收快照。但 leader 可能已經丟掉某個 follower 還需要的下一筆 entry,例如這個 follower 慢得特別多,或是剛加入叢集的新伺服器。這時 leader 改用 InstallSnapshot 這個 RPC,把快照分成多個區塊(chunk)依序送給它。
論文 Figure 13 列出的參數如下:
| 參數 | 意思 |
|---|---|
term、leaderId | leader 的 term 與 ID,讓 follower 可以轉導用戶端 |
lastIncludedIndex、lastIncludedTerm | 快照取代的最後一筆 entry 的 index 與 term |
offset、data[] | 這個區塊在快照檔中的位置與原始位元組 |
done | 是否為最後一個區塊 |
follower 收到快照後,要決定怎麼處理自己現有的 log:
- 快照含有新資訊(通常如此):follower 丟掉整份 log,因為已被快照取代,而且可能有與快照衝突的未 committed entry;再用快照的內容重設狀態機。
- 快照只是它 log 的前一段(因重送或誤送):被快照涵蓋的 entry 刪掉,快照之後的 entry 仍然有效,必須保留。
論文也說明,快照分區塊傳送,是為了讓 follower 每收到一塊就有一個「還活著」的訊號,可以重設自己的 election timer。
什麼時候做快照
論文列出兩個影響效能的問題:
- 什麼時候做:太頻繁會浪費磁碟頻寬與電力,太少則可能把儲存空間用完,而且重新啟動後重播 log 的時間更長。簡單的策略是 log 達到固定的位元組大小就做快照;把這個大小設得比預期的快照大得多,快照的磁碟頻寬負擔就會很小。
- 寫快照會不會卡住正常運作:寫快照可能花不少時間。解法是用 copy-on-write 技術,讓新的更新在快照寫入期間仍能進來。例如用 functional data structure 實作的狀態機天然支援;也可以用作業系統的 copy-on-write(例如 Linux 的
fork),論文的實作就採用這種做法。
論文另外提到 log cleaning、LSM tree 這類漸進式的壓縮方式,每次只處理一部分資料,但機制比快照複雜;快照每次處理整份資料,所以較單純。
補充說明:etcd 的 Raft 函式庫把 log compaction 列在功能清單裡。它的內部文件描述,leader 在取不到要送給某個 follower 的 term 或 entry 時,會改送
MsgSnap訊息請對方安裝快照,對應論文裡的InstallSnapshot。
唯讀請求:怎麼確保讀到最新的資料
問題在哪裡
唯讀請求只查詢狀態機、不改變它,所以可以不寫進 log。這樣省掉同步寫入磁碟的時間,效能比較好;但如果沒有額外措施,可能讀到舊資料。
舉例來說,leader 被網路分割到少數那一邊,多數那邊已經選出新 leader 並 commit 了新的 entry。被隔開的舊 leader 如果不問其他伺服器就直接回答讀取,回傳的是舊結果。這種結果不滿足線性一致性(linearizability,每次讀取都必須看到最新已 committed 的寫入),只能算是較弱的 serializability。
ReadIndex:與過半數確認後再讀
博士論文描述的做法,讓 leader 在不寫 log 的情況下仍保持線性一致性,步驟如下:
- 如果 leader 還沒有任何屬於目前 term 的 entry committed,就先等。為此 Raft 讓每個 leader 在 term 開始時,先 commit 一筆空白的 no-op entry;它 committed 之後,leader 的 commit index 就不會比其他伺服器的小。
- leader 把目前的 commit index 存成區域變數 readIndex,當作這次讀取所依據的狀態的下限。
- leader 發出新一輪心跳,等過半數伺服器回應。收到後,它就知道心跳送出的那一刻不存在 term 更大的 leader,所以 readIndex 當時是整個叢集見過最大的 commit index。
- leader 等自己的狀態機套用到至少 readIndex 的位置。
- leader 對狀態機執行查詢,並把結果回給用戶端。
這比把讀取也當成 log entry 複製更有效率,因為省掉同步寫磁碟。leader 還可以用同一輪心跳來確認多個累積的讀取請求,攤平成本。
follower 也可以分擔讀取:follower 向 leader 要一個目前的 readIndex(leader 執行上面的步驟 1 到 3),之後在自己的狀態機執行步驟 4 與 5。etcd 的 Raft 函式庫 README 列出的功能也包含這種由 leader 與 follower 都能處理的線性一致讀取:follower 先向 leader 取得安全的 read index。
Lease read:用時鐘省掉心跳
另一種做法是靠時鐘而不是訊息。leader 的心跳被過半數伺服器確認後,可以假設在大約一個 election timeout(博士論文的圖示還要依時鐘漂移上限折算)內,不會有其他伺服器成為 leader,這段租約期間就能直接回答讀取,完全不需要通訊。
代價是它要假設各台伺服器的時鐘漂移有上限。博士論文指出,要找出並維持這個上限在實務上不容易,例如垃圾回收暫停、虛擬機遷移、時鐘速率調整都可能破壞它;一旦假設不成立,系統可能回傳任意舊的資訊。所以博士論文不建議使用,除非效能需求真的需要。
| 做法 | 讀取時要與過半數通訊嗎 | 安全性依賴 |
|---|---|---|
| 讀取也當成 log entry 複製 | 要,走完整的複製流程 | 不依賴時間 |
| ReadIndex | 要,一輪心跳,可由多個讀取共用 | 不依賴時間 |
| Lease read | 不用 | 時鐘漂移有上限 |
etcd 的 Raft 函式庫把這兩種做法做成設定:ReadOnlySafe 是預設,也是函式庫建議的選項,靠與過半數通訊來保證線性一致性;ReadOnlyLeaseBased 則依賴 leader 租約,會受時鐘漂移影響,而且啟用時必須同時開啟 CheckQuorum。
實際系統的取捨
etcd 的 API 保證文件說明,預設所有其他操作都是線性一致的,代價是這類請求必須經過 Raft 共識流程;要取得較低延遲與較高吞吐量,用戶端可以把讀取的一致性模式設為 serializable,但可能讀到相對於過半數而言的舊資料。這個取捨與論文討論的是同一件事:要不要為了新鮮度付出與過半數通訊的代價。
補充說明:寫入也有類似但不同的問題。leader 可能在 commit 一筆指令之後、回覆用戶端之前當機,用戶端重試會讓同一個指令被執行兩次。論文的解法是讓用戶端替每個指令附上唯一序號,狀態機記錄每個用戶端最後處理的序號與回應,遇到重複的序號就直接回覆先前的結果,不再執行。

發佈留言