ASCII 是什麼?ASCII(American Standard Code for Information Interchange)是一套字元編碼標準,用 7 位元表示 128 個字元,涵蓋英文字母、數字、標點符號與控制碼,讓電腦與其他裝置能把這些內容轉成數位資料。寫程式時碰到 charCodeAt()、ord()、換行字元或 URL 編碼,背後幾乎都會看到 ASCII 的影子。本文帶你看懂 ASCII 編碼表、控制字元,以及它和 Unicode、UTF-8 之間的關係。
ASCII 是什麼:7 位元、128 個字元
ASCII 的原始規格收錄在 1969 年的 RFC 20(ASCII format for Network Interchange)。這份文件建議的用法是:把標準 7 位元 ASCII 放進一個 8 位元的位元組,而且這個位元組的最高位元永遠是 0。
7 個位元共有 2 的 7 次方,也就是 128 種組合,所以 ASCII 的編號範圍是 0 到 127。MDN 的詞彙表也是這樣定義:ASCII 使用 7 位元表示 128 個字元,包含字母、數字、標點符號與控制碼。
這 128 個位置可以分成兩大類:
- 控制字元:編號 0 到 31,再加上 127 的
DEL,用來控制裝置或格式,例如換行、跳格、響鈴。 - 可顯示字元:編號 32(空白)到 126,包含空白、阿拉伯數字、大小寫英文字母與標點符號。
ASCII 編碼表怎麼看
RFC 20 把編碼表畫成 8 欄(0 到 7)乘 16 列(0 到 15)的表格。欄號由第 7、6、5 位元決定,列號由第 4 到第 1 位元決定。下面這張表把欄與列都換成十六進位,格子內是該編號的字元或控制字元縮寫,SP 代表空白:
十六進位  0_   1_   2_   3_   4_   5_   6_   7_
_0       NUL  DLE  SP   0    @    P    `    p
_1       SOH  DC1  !    1    A    Q    a    q
_2       STX  DC2  "    2    B    R    b    r
_3       ETX  DC3  #    3    C    S    c    s
_4       EOT  DC4  $    4    D    T    d    t
_5       ENQ  NAK  %    5    E    U    e    u
_6       ACK  SYN  &    6    F    V    f    v
_7       BEL  ETB  '    7    G    W    g    w
_8       BS   CAN  (    8    H    X    h    x
_9       HT   EM   )    9    I    Y    i    y
_A       LF   SUB  *    :    J    Z    j    z
_B       VT   ESC  +    ;    K    [    k    {
_C       FF   FS   ,    <    L    \    l    |
_D       CR   GS   -    =    M    ]    m    }
_E       SO   RS   .    >    N    ^    n    ~
_F       SI   US   /    ?    O    _    o    DEL
查法是「欄的數字接列的數字」。例如大寫 A 在 4_ 欄、_1 列,組合起來是十六進位 0x41,換成十進位就是 65。小寫 a 在 6_ 欄、_1 列,是 0x61,也就是 97。
幾個好用的規律可以直接從表上看出來:
- 阿拉伯數字
0到9是0x30到0x39(十進位 48 到 57)。 - 大寫字母
A到Z是0x41到0x5A(65 到 90)。 - 小寫字母
a到z是0x61到0x7A(97 到 122)。 - 同一個英文字母的小寫與大寫,編號差 32(
0x20),也就是表上相鄰兩欄的差距,例如 97 減 65 等於 32。
WHATWG Infra 標準對這幾段範圍有同樣的定義,例如 ASCII digit 是 U+0030 到 U+0039,ASCII upper alpha 是 U+0041 到 U+005A,ASCII lower alpha 是 U+0061 到 U+007A。
ASCII 控制字元:編號 0 到 31 與 DEL
編碼表最左邊兩欄(0_ 與 1_)放的是控制字元,它們不是用來顯示的符號,而是原本用來控制通訊與輸出裝置的指令。RFC 20 的圖例列出每個控制字元的英文名稱,整理如下:
| 十進位 | 十六進位 | 縮寫 | RFC 20 英文名稱 |
|---|---|---|---|
| 0 | 0x00 | NUL | Null |
| 1 | 0x01 | SOH | Start of Heading |
| 2 | 0x02 | STX | Start of Text |
| 3 | 0x03 | ETX | End of Text |
| 4 | 0x04 | EOT | End of Transmission |
| 5 | 0x05 | ENQ | Enquiry |
| 6 | 0x06 | ACK | Acknowledge |
| 7 | 0x07 | BEL | Bell |
| 8 | 0x08 | BS | Backspace |
| 9 | 0x09 | HT | Horizontal Tabulation |
| 10 | 0x0A | LF | Line Feed |
| 11 | 0x0B | VT | Vertical Tabulation |
| 12 | 0x0C | FF | Form Feed |
| 13 | 0x0D | CR | Carriage Return |
| 14 | 0x0E | SO | Shift Out |
| 15 | 0x0F | SI | Shift In |
| 16 | 0x10 | DLE | Data Link Escape |
| 17 | 0x11 | DC1 | Device Control 1 |
| 18 | 0x12 | DC2 | Device Control 2 |
| 19 | 0x13 | DC3 | Device Control 3 |
| 20 | 0x14 | DC4 | Device Control 4 |
| 21 | 0x15 | NAK | Negative Acknowledge |
| 22 | 0x16 | SYN | Synchronous Idle |
| 23 | 0x17 | ETB | End of Transmission Block |
| 24 | 0x18 | CAN | Cancel |
| 25 | 0x19 | EM | End of Medium |
| 26 | 0x1A | SUB | Substitute |
| 27 | 0x1B | ESC | Escape |
| 28 | 0x1C | FS | File Separator |
| 29 | 0x1D | GS | Group Separator |
| 30 | 0x1E | RS | Record Separator |
| 31 | 0x1F | US | Unit Separator |
| 127 | 0x7F | DEL | Delete |
新手日常最常碰到的是這幾個:
HT(9):水平跳格(Tab),在字串裡寫成\t。LF(10):換行,在字串裡寫成\n。CR(13):Carriage Return,字串裡寫成\r。NUL(0):全部位元都是 0 的字元。ESC(27):Escape。SP(32):空白,嚴格來說它不是控制字元,RFC 20 把它列為「通常不列印、用來分隔單字的圖形字元」。
DEL(127)比較特別。RFC 20 說明它原本用在穿孔紙帶上「抹除」錯誤的字元,並且指出嚴格來說 DEL 不是控制字元。不過 WHATWG Infra 對「control」的定義,是 U+0000 到 U+001F 的 C0 control,再加上 U+007F 到 U+009F,所以在程式規格裡 DEL 通常會一起被當成控制字元處理。
網頁規格裡也常出現「ASCII whitespace」這個詞。Infra 標準的定義是:U+0009 TAB、U+000A LF、U+000C FF、U+000D CR 與 U+0020 SPACE 這五個字元。HTML 的空格與全形空白怎麼處理,詳細可前往〈HTML 空格與空白字元使用(包含 與全形空白)〉。
用 JavaScript、Python 查字元的 ASCII 編號
JavaScript 的 charCodeAt() 可以取得字串中指定位置字元的編號,String.fromCharCode() 則反過來,由編號建立字元。Python 對應的函式是 ord() 與 chr()。
console.log('A'.charCodeAt(0));
console.log('a'.charCodeAt(0));
console.log('0'.charCodeAt(0));
console.log(String.fromCharCode(72, 105));
console.log('a'.charCodeAt(0) - 'A'.charCodeAt(0));
console.log('\n'.charCodeAt(0), '\t'.charCodeAt(0), ' '.charCodeAt(0));
console.log('中'.charCodeAt(0));

const encoder = new TextEncoder();
console.log(encoder.encode('A'));
console.log(encoder.encode('中'));
輸出結果依序是 65、97、48、Hi、32、10 9 32、20013,接著是 A 的 UTF-8 位元組 [65] 與 中 的 UTF-8 位元組 [228, 184, 173]:
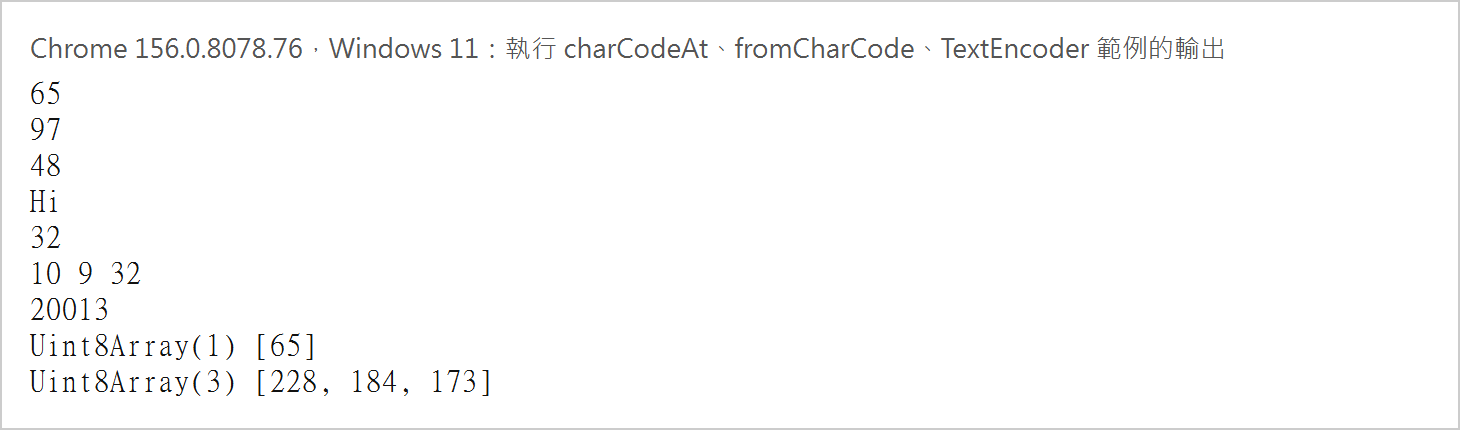
charCodeAt() 依 MDN 的說明,回傳的是 0 到 65535 的整數,代表該位置字元的 UTF-16 code unit;index 超出範圍時回傳 NaN。因此對 ASCII 範圍的字元,它剛好等於 ASCII 編號;對 中 這種字元,得到的是 Unicode 的編號 20013,而不是 ASCII 編號,因為它根本不在 ASCII 的 0 到 127 之內。
Python 的寫法如下,encode('ascii') 遇到 ASCII 範圍以外的字元會直接報錯:
print(ord('A'))
print(chr(97))
print('A'.encode('ascii'))
print('中'.encode('utf-8'))
try:
    '中'.encode('ascii')
except UnicodeEncodeError as e:
    print(e)
Python 3.10.11 在 Windows 11 的輸出如下:
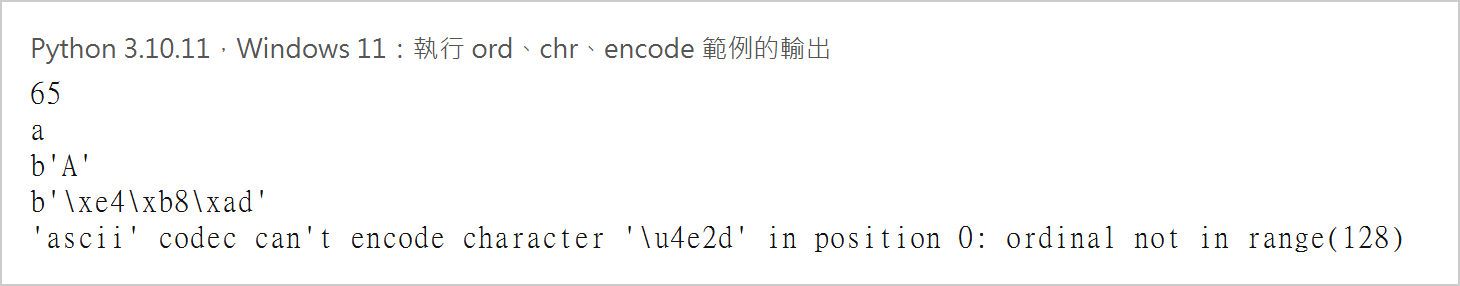
依 Python 文件,ord() 對單一字元字串回傳其 Unicode code point,chr() 則是它的反運算;ascii 編碼預設的錯誤處理是 strict,編碼失敗時會丟出 UnicodeEncodeError。中文字無法用 ASCII 表示,就是這個錯誤的由來。
ASCII 與 Unicode 的關係
ASCII 只有 128 個位置,放得下英文字母,卻放不下中文、日文或表情符號。Unicode 就是為了涵蓋各種文字而設計的:它的碼空間是整數 0 到 10FFFF(十六進位),每個字元對應一個編號,稱為 code point,寫法像 U+0041。
Unicode 標準說明,7 位元 ASCII 佔了 Unicode 前 128 個碼位。也就是說 U+0000 到 U+007F 的編號和 ASCII 的 0 到 127 一一對應,A 在 ASCII 是 65,在 Unicode 就是 U+0041,十六進位的 0x41 同樣是 65。WHATWG Infra 也把 ASCII code point 定義為 U+0000 NULL 到 U+007F DELETE。
要記得的是:Unicode 與 ASCII 是「編號」的關係,Unicode 本身不規定一個編號要用幾個位元組存起來。實際存成位元組的方式叫做編碼,UTF-8 就是其中一種。JavaScript 字串內部則是 UTF-16 code unit,所以 charCodeAt() 才會說回傳的是 UTF-16 code unit。想用 Unicode 編號建立字元,可前往〈JavaScript 使用 String.fromCodePoint() 將 Unicode 轉字元〉。
ASCII 與 UTF-8 的關係
RFC 3629 規定 UTF-8 用 1 到 4 個 octet(位元組)表示一個字元,編號範圍與位元組格式如下:
| Unicode 編號範圍 | UTF-8 位元組格式 |
|---|---|
U+0000 到 U+007F | 0xxxxxxx |
U+0080 到 U+07FF | 110xxxxx 10xxxxxx |
U+0800 到 U+FFFF | 1110xxxx 10xxxxxx 10xxxxxx |
U+10000 到 U+10FFFF | 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx |
第一列就是 ASCII 的範圍:RFC 3629 說明,U+0000 到 U+007F(US-ASCII 字元集)對應 octet 00 到 7F,用單一位元組表示,數值與 US-ASCII 相同。Unicode 標準也指出,這個範圍在 UTF-8 中會轉成單一位元組 0x00 到 0x7F。
這帶來兩個實用結論:
- 純 ASCII 的文字,用 ASCII 存和用 UTF-8 存,位元組內容完全一樣。上面的範例中
A的 UTF-8 位元組就是[65]。 - 不在 ASCII 範圍的字元,UTF-8 會用多個位元組。
中的編號是U+4E2D(20013),落在第三列,所以是 3 個位元組:[228, 184, 173],十六進位是E4 B8 AD。
UTF-8 檔案開頭的 BOM、超過 U+FFFF 的字元如何在 JavaScript 字串中表示,以及 Unicode 正規化,都是在 ASCII 之外才會碰到的主題,這篇先不展開。
ASCII 常見問題
ASCII 總共有幾個字元?
128 個,編號 0 到 127,其中 33 個是控制字元(0 到 31 與 127),其餘是 95 個可顯示字元(含空白)。
空白是 ASCII 字元嗎?
是。空白(SP)的編號是 32(0x20),位於編碼表 2_ 欄的第一列。
中文字是 ASCII 嗎?
不是。中文字不在 ASCII 的 0 到 127 之內,必須用 Unicode 搭配 UTF-8 等編碼表示。範例中用 ascii 編碼處理 中 會得到 UnicodeEncodeError。
全形英數是 ASCII 嗎?
不是。ASCII 的英數字元是半形,全形英數不在 0 到 127 之內。轉換方式可前往〈JS 半形轉全形與 String.prototype.normalize 字元轉換〉。
網址裡的非 ASCII 字元怎麼處理?
網址遇到中文等非 ASCII 字元時,會做百分比編碼,JavaScript 的處理方式可前往〈JS 中的 URL 編碼(encode)與解碼(decode)方法〉。
參考資料與延伸閱讀
- RFC 20:ASCII format for Network Interchange
- RFC 3629:UTF-8, a transformation format of ISO 10646
- The Unicode Standard 16.0 第 2 章:General Structure
- Infra Standard:Code points(WHATWG)
- ASCII:MDN 詞彙表
- String.prototype.charCodeAt():MDN
- String.fromCharCode():MDN
- TextEncoder:MDN
- Python 內建函式 ord()、chr()
- Python codecs:Standard Encodings
- JavaScript 使用 String.fromCodePoint() 將 Unicode 轉字元
- JS 半形轉全形與 String.prototype.normalize 字元轉換
- JS 中的 URL 編碼(encode)與解碼(decode)方法
- HTML 空格與空白字元使用(包含 與全形空白)

發佈留言